Forestil dig at ansætte en ny medarbejder. Den ene kandidat er en "alsidig mand" – ved lidt om alt, men ikke i dybden. Den anden har 10 års erfaring i netop din branche. Hvem stoler du på med dine kritiske forretningsbeslutninger?
Det er forskellen mellem generelle store sprogmodeller ( LLM'er ) og domænespecifikke LLM'er . Mens generelle modeller som GPT-4 eller Gemini er brede og fleksible, er domænefokuserede LLM'er trænet eller finjusteret til et bestemt felt - såsom medicin, jura, finans eller ingeniørvidenskab.
I dette indlæg vil vi udforske, hvad domænespecifikke LLM'er er, fremhæve eksempler fra den virkelige verden, diskutere, hvordan man opbygger dem, og dække både deres fordele og begrænsninger.
Hvad er domænespecifikke LLM'er?
En domænespecifik LLM er en AI-model, der er optimeret til at udmærke sig inden for et snævert, specialiseret område i stedet for generel sprogforståelse. Disse modeller skabes ofte ved at finjustere store fundamentmodeller med omhyggeligt kuraterede datasæt fra måldomænet.
👉 Tænk på en schweizerkniv kontra en skalpel . En generel LLM kan håndtere mange opgaver rimeligt godt (som den schweizerkniv). Men en domænespecifik LLM er skarp, præcis og bygget til specialiserede opgaver (som skalpelen).
Eksempler på domænespecifikke LLM'er
Domænespecialiserede modeller skaber allerede bølger på tværs af brancher:
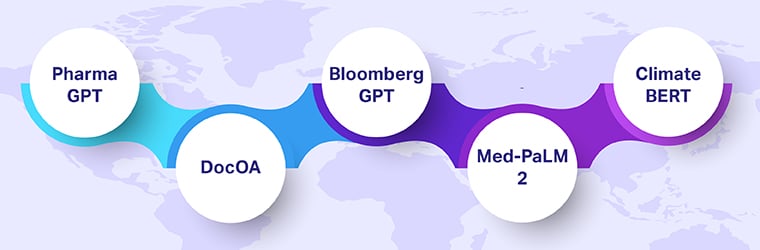
- PharmaGPT – En model fokuseret på biofarma og lægemiddeludvikling. Ifølge nyere forskning (arXiv:2406.18045) viser den stærkere præcision på biomedicinske opgaver, mens der anvendes færre ressourcer end GPT-4.
- DocOA – En klinisk model skræddersyet til slidgigt. Benchmarket i 2024 (arXiv:2401.12998) overgik den generelle LLM'er i specialiserede medicinske ræsonnementopgaver.
- BloombergGPT – Bygget til finansmarkeder, trænet på en blanding af offentlige finansielle dokumenter og proprietære datasæt. Understøtter investeringsanalyse, compliance og risikomodellering.
- Med-PaLM 2 – Denne sundhedsfokuserede model, der er udviklet af Google DeepMind, opnår avanceret nøjagtighed i besvarelsen af spørgsmål i forbindelse med lægeundersøgelser.
- KlimaBERT – En sprogmodel trænet i klimavidenskabelig litteratur, der hjælper forskere med at analysere bæredygtighedsrapporter og klimaoplysninger.
Hver af disse demonstrerer, hvordan dyb specialisering kan overgå generelle giganter i målrettede sammenhænge.
Fordele ved domænespecifikke LLM'er
Hvorfor har virksomheder travlt med at opbygge deres egne domæne-LLM'er? Flere vigtige fordele skiller sig ud:
Sådan opbygger du en domænespecifik LLM
Der findes ingen universel løsning, men processen involverer normalt disse nøgletrin:
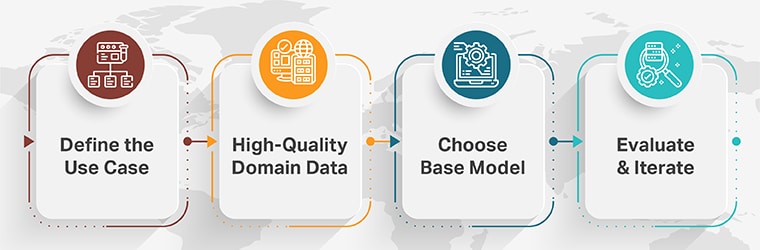
1. Definer brugsscenariet
Identificér, om målet er kundesupport, compliance-overvågning, lægemiddelforskning, juridisk analyse eller en anden domænespecifik opgave.
2. Indsaml domænedata af høj kvalitet
Indsaml kommenterede datasæt fra din branche. Kvalitet er vigtigere end kvantitet her: et mindre datasæt med høj kvalitet klarer sig ofte bedre end et stort, men støjende et.
3. Vælg en basismodel
Start med en generel grundlæggende model (som LLaMA, Mistral eller GPT-4) og tilpas den til domænet.
- FinjusteringTræning i domænespecifikke data for at justere vægte.
- Retrieval-Augmented Generation (RAG)Forbinder modellen til en vidensbase for at sikre realtidsbasis.
- Små LLM'er (SLM'er)Træning af kompakte modeller, der er effektive, men yderst specialiserede.
4. Evaluer og gentag
Benchmark mod generelle LLM'er for at sikre forbedringer i nøjagtighed. Spor hallucinationsrater, latenstid og compliance-målinger.
Domænespecifikke vs. generelle LLM'er
Hvordan klarer domænespecialiserede modeller sig i forhold til deres generelle modparter? Lad os sammenligne: