I vores bestræbelser på at bygge robuste og upartiske AI-løsninger er det vigtigt, at vi fokuserer på at træne modellerne på et upartisk, dynamisk og repræsentativt datasortiment. Vores dataindsamlingsproces er ekstremt vigtig for at udvikle troværdige AI-løsninger. I denne henseende bliver indsamling af AI-træningsdata gennem crowdworkere et kritisk aspekt af dataindsamlingsstrategien.
I denne artikel vil vi undersøge rollen af crowdworkere, deres indflydelse på udviklingen af AI- læringsalgoritmer og ML-modeller, samt behovet for og fordelene ved hele processen.
Hvorfor er crowd workers forpligtet til at bygge AI-modeller?
Som mennesker genererer vi tonsvis af data, men kun en brøkdel af disse genererede og indsamlede data er af værdi. På grund af manglen på standarder for databenchmarking er de fleste af de indsamlede data enten forudindtagede, fyldt med kvalitetsproblemer eller ikke repræsentative for miljøet. Da der udvikles flere og flere maskinlærings- og deep learning-modeller, der trives på enorme mængder data, mærkes behovet for bedre, nyere og forskelligartede datasæt i stigende grad.
Det er her crowd workers kommer i spil.
Crowd-sourcing-data bygger et datasæt med deltagelse af store grupper af mennesker. Crowd-arbejdere tilfører menneskelig intelligens til kunstig intelligens.
Crowdsourcing-platforme giver mikroopgaver inden for dataindsamling og annotering til en stor og diversificeret gruppe af mennesker. Crowdsourcing giver virksomheder adgang til en massiv, dynamisk, omkostningseffektiv og skalerbar arbejdsstyrke.
Den mest populære crowdsourcing-platform – Amazon Mechanical Turk – var i stand til at indsamle 11 menneske-til-menneske-dialoger inden for 15 timer og betalte medarbejderne 0.35 dollars for hver vellykket dialog. Crowdworkere bliver engageret for et beskedent beløb, hvilket kaster lys over vigtigheden af at opbygge etiske standarder for data sourcing.
Teoretisk set lyder det som en smart plan, men alligevel er det ikke en nem strategi at udføre. Anonymiteten for crowd-arbejderne har givet anledning til problemer med lav løn, tilsidesættelse af arbejdstagerrettigheder og dårlig kvalitetsarbejde, der påvirker AI-modellens ydeevne.
Fordele ved at have crowd workers til at hente data
Ved at engagere en mangfoldig gruppe af crowd workers kan AI-baserede løsningsudviklere distribuere mikroopgaver og samle varierede og udbredte observationer hurtigt og til en relativt lav pris.
Nogle af de fremtrædende fordele ved at ansætte crowd workers til AI-projekter er
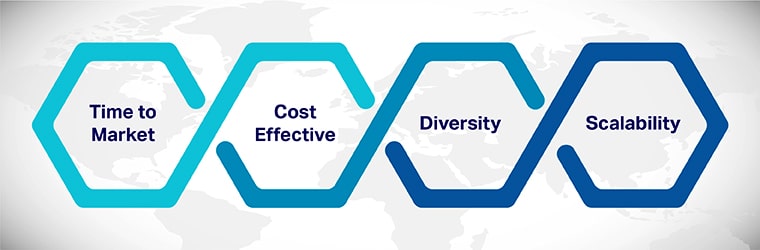
Hurtigere tid til markedet: Ifølge forskning fra Cognilytica bruges næsten 80 % af tiden i kunstig intelligens- projekter på dataindsamlingsaktiviteter såsom datarensning, mærkning og aggregering. Kun 20 % af tiden bruges på udvikling og træning. De traditionelle barrierer for datagenerering elimineres, da et stort antal bidragydere kan rekrutteres inden for kort tid.
Omkostningseffektiv løsning: Crowdsourcing af dataindsamling reducerer den tid og energi, der bruges på træning, rekruttering og ombordtagning. Dette eliminerer de omkostninger, den tid og de ressourcer, der kræves, da arbejdsstyrken er ansat efter en pay-per-task-metode.
Øger diversiteten i datasættet: Datadiversitet er afgørende for hele træningen af AI-løsningen. For at en model kan producere upartiske resultater, skal den trænes på et forskelligartet datasæt. Med crowdsourcing af data er det muligt at generere forskellige (geografiske, sproglige, dialektiske) datasæt med minimal indsats og omkostninger.
Forbedrer skalerbarhed: Når du rekrutterer pålidelige crowd workers, kan du sikre dataindsamling af høj kvalitet , der kan skaleres baseret på dine projektbehov.

In-house vs. crowdsourcing – Hvem kommer ud som vinderen?
| In-house data | Crowdsourced data |
|---|---|
| Datanøjagtighed og konsistens kan garanteres. | Datakvalitet, nøjagtighed og konsistens kan opretholdes, hvis pålidelige crowd-sourcing-platforme med standard QA-foranstaltninger er engageret |
| In-house data sourcing er ikke altid en praktisk beslutning, da dit interne team muligvis ikke opfylder projektkravene. | Datadiversitet kan sikres, da det er muligt at rekruttere en heterogen gruppe af crowd workers baseret på projektets behov. |
| Dyrt at rekruttere og uddanne medarbejdere til projektets behov. | Omkostningseffektiv løsning på dataindsamling da det er muligt at rekruttere, uddanne og ombord medarbejdere med færre investeringer. |
| Time to market er høj, da intern dataindsamling tager lang tid. | Time to market er væsentligt mindre, da mange bidrag kommer hurtigt. |
| En lille gruppe af interne bidragydere og etikette | En stor og mangfoldig gruppe af bidragydere og dataetiketter |
| Datafortroligheden er meget høj med et internt team. | Datafortrolighed er vanskelig at opretholde, når man arbejder med store menneskemængder over hele verden. |
| Lettere at spore, træne og evaluere dataindsamlerne | Udfordrende at spore og træne dataindsamlerne. |
Bygge bro mellem crowdsource-medarbejdere og anmoderen.
Der er en åbenlys mangel på information fra anmoderens side, fordi medarbejderne kun får information om den specifikke opgave. For eksempel, selvom medarbejderne får mikroopgaver såsom at optage dialoger på deres modersmål, får de sjældent kontekst. De har ikke den nødvendige information om, hvorfor de gør, hvad de gør, og hvordan de bedst gør det. Denne mangel på information påvirker kvaliteten af det crowdsourcede arbejde.
For et menneske giver det at have hele konteksten klarhed og formål til deres arbejde.
Tilføj til denne blanding endnu en dimension af NDA - tavshedspligten, som begrænser mængden af information, som en crowd worker leveres. Fra et crowd worker-perspektiv viser denne tilbagetrækning af information en mangel på tillid og mindsket betydning for deres arbejde.
Når den samme situation ses fra den anden ende af spektret, mangler der gennemsigtighed fra medarbejderens side. Anmoderen forstår ikke fuldt ud den medarbejder, der er bestilt til at udføre arbejdet. Nogle projekter kræver muligvis en bestemt type medarbejder; i de fleste projekter er der dog tvetydighed. Sandheden er , at dette kan komplicere evaluering, feedback og træning senere hen.
For at imødegå disse vanskeligheder er det vigtigt at arbejde med dataindsamlingseksperter, der har en track record i at levere forskelligartede, kurerede og velrepræsenterede data fra et bredt udvalg af bidragydere.
At vælge Shaip som din datapartner kan have flere fordele. Vi fokuserer på mangfoldighed og repræsentative distributioner af data. Vores erfarne og dedikerede medarbejdere forstår tvangene ved hvert projekt og udvikler datasæt, der kan træne robuste AI-baserede løsninger på ingen tid.
[Læs også: Guide til start af AI-træningsdata: Definition, eksempel, datasæt ]