Multimodal AI: Den komplette guide til træningsdata, modeller og brugsscenarier
Alligevel undervurderer de fleste teams, hvad det rent faktisk kræver at opbygge disse data. De behandler det som et mærkningsjob. Det er det ikke. Det er en koordineringsudfordring: flere datatyper indsamlet synkront, kommenteret med konsistente skemaer og justeret på tværs af modaliteter, før en model overhovedet ser et eneste eksempel.
Hos Shaip, nu en del af Ubiquity-økosystemet, arbejder vi med AI-teams, der opbygger datasæt på tværs af tekst, tale, billede, video, sensorer og medicinske billeddannelsesmodaliteter. De mønstre, der adskiller højtydende multimodale modeller fra dyre fejl, afhænger af tidlige beslutninger om datakvalitet – beslutninger, som denne guide gennemgår.
Ved udgangen af denne artikel vil du forstå, hvordan multimodale modeller lærer, hvor de førende modeller i 2026 får deres fordel, hvilke brancher der implementerer multimodal AI i stor skala med verificerede resultater, og præcis hvordan du finder de data, der får det til at fungere.
Hvad er multimodale AI-træningsdata?
Multimodale AI-træningsdata er en struktureret samling af parrede eller sammenflettede input fra to eller flere datamodaliteter – såsom billeder med teksttekster, lydoptagelser med transskriptioner eller video med synkroniserede sensoraflæsninger – der bruges til at træne AI-modeller til at forstå og ræsonnere på tværs af disse modaliteter sammen. I modsætning til unimodale datasæt, der træner modeller på en enkelt datatype, kræver multimodale datasæt tværmodal justering: hvert eksempel skal formidle ensartet betydning på tværs af alle tilstedeværende modaliteter.
Sondringen er vigtig i praksis. En tekstbaseret model, der er trænet på kliniske notater, lærer at forudsige diagnoser ud fra ord. En multimodal model, der er trænet på kliniske notater og de tilsvarende billeddata, kan fange mønstre, som ingen af modaliteterne afslører alene. Denne kombination kræver en fundamentalt anderledes tilgang til dataindsamling, annotering og kvalitetskontrol.
Shaips multimodale træningsdatatjenester dækker seks kernemodaliteter:
| Modalitet | Eksempler | Tilfælde af primær brug |
|---|---|---|
| tekst | Dokumenter, udskrifter, prompts | LLM'er, NLP, dokument AI |
| Billede | Fotos, medicinske scanninger, satellitbilleder | Computervision, diagnostik |
| Audio | Tale, miljølyde, musik | ASR, sentiment, stemme-AI |
| Video | Overvågning, produktdemonstrationer, medicinske procedurer | Handlingsgenkendelse, overvågning |
| Sensor / LiDAR | IMU, radar, dybdesensorer | Selvkørende køretøjer, robotteknologi |
| Medicinsk billeddannelse | CT, MR, DICOM, røntgen | Klinisk AI, radiologi |
Unimodal vs. multimodal – et overblik:

Rejsen fra single-mode til multimodal AI repræsenterer et betydeligt teknologisk fremskridt. Tidlige AI-systemer var højt specialiserede – billedklassificeringssystemer kunne identificere objekter, men kunne ikke forstå tilhørende tekstbeskrivelser, mens processorer med naturligt sprog kunne analysere følelser, men overså visuelle signaler, der gav afgørende kontekst.
| faktor | unimodal | multimodal |
|---|---|---|
| Datatyper | En (f.eks. kun tekst) | To eller flere, parret |
| Modeleksempler | GPT-4 (tekst), DALL-E (billede) | GPT-4o, Gemini 2.5, Llama 4 |
| Annotationskompleksitet | Medium | Høj (påkrævet tværgående konsistens) |
| Brug sager | NLP-opgaver, billedklassificering | Diagnostik, autonome systemer, RAG |
| Nødvendig datamængde | Høj | Meget høj (10 gange+ mere pr. modalitet) |
At forstå, hvad multimodale data er, baner vejen for at forstå, hvordan modeller rent faktisk bruger dem – og det er her, de fleste teams finder de første hårde overraskelser.
Hvordan multimodale AI-modeller rent faktisk lærer
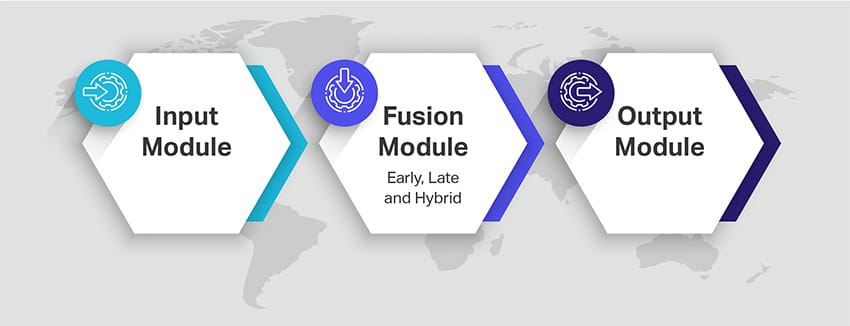
Enhver multimodal model kører på den samme tretrins-pipeline: encode, fuse, decode. Hvad der sker i hvert trin, bestemmer, hvilken slags træningsdata du har brug for.
Trin 1: Enkodere — Konvertering af rådata til vektorer
Hver modalitet går ind gennem en specialiseret encoder, der konverterer rå input til en numerisk indlejring. En visionsencoder (typisk et konvolutionelt netværk eller en Vision Transformer) konverterer et billede til en featurevektor. En tekstencoder, normalt transformerbaseret, gør det samme for tekst. En lydencoder behandler frekvensmønstre fra tale eller lyd.
Disse encodere kan trænes fra bunden eller initialiseres fra præ-trænede modeller som OpenAI's CLIP , der lærer et delt indlejringsområde for billeder og tekst at kende ved at træne på 400 millioner billedtekstpar. Kvaliteten af dine træningsdata på dette stadie bestemmer, hvor godt hver encoder generaliserer til dit domæne.
Fase 2: Fusion — Hvor modellen opbygger tværmodal forståelse
Fusion er der, hvor multimodal læring rent faktisk finder sted. Modellen skal forene indlejringer fra forskellige modaliteter i en enkelt repræsentation. Der er fire hovedstrategier:
- Tidlig fusion: Rå input kombineres før kodning. Simpelt, men følsomt over for støj i enhver modalitet.
- Sen fusion: Hver modalitet er kodet separat og kombineret på beslutningslaget. Mere robust, men mangler potentielt finmaskede tværmodale relationer.
- Hybrid fusion: En blanding af begge dele, hvor nogle modaliteter bearbejdes i fællesskab og andre uafhængigt.
- Dynamisk (adaptiv) fusion: Modellen lærer at vægte hver modalitet baseret på inputkvalitet på inferenstidspunktet. Hvis lyden er støjende, nedvægter modellen den automatisk. Denne tilgang, der er dækket i nyere arbejde fra Encords ICLR 2026-analyse, betragtes nu som bedste praksis for produktionsimplementeringer.
[OPFORDRING: Krydsmodal opmærksomhed er den mekanisme, der gør fusion præcis. Oprindeligt demonstreret i ViLBERT-arkitekturen (Lu et al., 2019) og raffineret i CLIP og ALIGN, fungerer det ved at beregne opmærksomhedsscorer mellem tokens fra forskellige modaliteter - for eksempel ved at justere ordet "revne" i en vedligeholdelsesrapport med det specifikke område af et røntgenbillede, hvor en fraktur optræder. Træningsdatakvaliteten bestemmer direkte, hvor præcist disse opmærksomhedsrelationer dannes.]
Fase 3: Dekoder — Produktion af output
Dekoderen genererer modellens output: et tekstsvar, en afgrænsningsboks, en klassifikationsetiket eller et genereret billede. For at dekoderen kan være pålidelig, skal fusionslaget have set nok korrekt justerede eksempler under træningen til at lære stabile tværmodale associationer.
Dette har en direkte implikation for dit datasæt: forkert justerede par - et lydklip parret med den forkerte transskription eller et billede med en beskrivelse af en anden scene - ødelægger fusionslagets læring. Ét forkert mærket eksempel i et parret datasæt forårsager mere skade end ét forkert mærket eksempel i et unimodalt datasæt, fordi det vildleder to modaliteter samtidigt.
Shaips dataannotations- og mærkningsproces inkluderer tværmodale konsistenskontroller i alle faser af netop denne grund.
Det multimodale AI-modellandskab i 2026
Hvilke AI-modeller bruger multimodale træningsdata? Alle førende fundamentsmodeller, der er udgivet siden 2023, er enten native multimodale eller tilføjer aktivt modaliteter. GPT-4o, Gemini 2.5, Claude 3.7 Sonnet, Llama 4 Scout og Maverick samt Phi-4 behandler alle mindst to modaliteter native. Finjustering af en af dem på domænespecifikke opgaver kræver domænespecifikke multimodale træningsdata – og det er i disse data, at din konkurrencefordel ligger.
Sådan opdeles landskabet i 2026 efter modalitet og implikationer for træningsdata:
| Model | Udvikler | Kernemodaliteter | Vigtig indsigt i træningsdata |
|---|---|---|---|
| GPT-4o | OpenAI | Tekst, billede, lyd (oprindelig) | Visuelt sprogpar; native lyd kræver data om justering af tale og tekst |
| Gemini 2.5 Pro | Google DeepMind | Tekst, billede, video, lyd, kode | Trænet i sammenflettede multimodale data; stærk i lange kontekst video-tekst opgaver |
| Claude 3.7 sonet | Antropisk | Tekst, billede (dokumenter, diagrammer) | Optimeret til brug i dokument-AI; stærk på strukturerede billede-tekst-par |
| Llama 4 Spejder / Maverick | Meta | Tekst, billede (sammenflettet) | Åben vægt; bruger sammenflettet billed-tekst-træning (som i Flamingo) |
| Phi-4 | microsoft | Tekst, billede, lyd | Designet til implementering på kanten; effektiv multimodal inferens fra kompakte datasæt |
| Qwen2.5-VL | Alibaba | Tekst, billede, video | Stærk visuel forståelse; bredt anvendt til finjustering af open source-data |
Modellandskabet udvikler sig hurtigt. Som ByteByteGo bemærker , sluttede æraen med tekstbaserede modeller reelt i 2025. I 2026 vil cirka 60 % af virksomhedsapplikationer være bygget ved hjælp af modeller, der kombinerer to eller flere modaliteter.
Hvad dette betyder for dit team: Selve modellen er i stigende grad en handelsvare. Differentiatoren er domænespecifikke træningsdata. En generel model, der er finjusteret på 50,000 domænetilpassede multimodale eksempler af høj kvalitet fra din branche, vil konsekvent overgå en generel model, der bruges direkte.
Multimodale træningsdata efter branche
Forskellige brancher har brug for forskellige kombinationer af modaliteter. Her er fem vertikaler, hvor multimodal AI er gået fra pilotprojekt til produktion – med verificerede offentlige implementeringer.
1. Sundhedspleje: Kombination af billeddannelse, kliniske noter og tale
Google DeepMinds Med-Gemini (2024) demonstrerede, hvad der sker, når multimodale træningsdata indsamles i stor skala. Forskningen, der blev offentliggjort i Nature i 2024 af Saab et al., viste, at en multimodal model, der var trænet på medicinske billeder, kliniske notater og patienthistorie, klarede sig betydeligt bedre end unimodale baselines på tværs af 14 medicinske benchmarks - herunder generering af radiologirapporter og analyse af patologibilleder.
Kravene til træningsdata er strenge: billeddata skal være DICOM-kompatible, patientjournaler skal være anonymiserede i henhold til HIPAA-standarder, og taledata fra lægediktat skal transskriberes med nøjagtighed i medicinsk ordforråd. Shaips katalog over træningsdata for sundhedsvæsenet leverer anonymiserede, HIPAA-kompatible datasæt på tværs af CT-, røntgen-, MR-, lægediktat- og EHR-data - bygget specielt til teams, der træner kliniske AI-modeller.
2. Autonome køretøjer og robotteknologi: Sensorfusion i stor skala

Teslas fuldt selvkørende system bruger data fra otte kameraer, ultralydssensorer og en fremadrettet radar – og behandler alle strømme samtidigt for at træffe kørselsbeslutninger i realtid. Træningsdatasættet er bygget op fra millioner af kilometer på vejen med annotering på billedniveau på tværs af hver sensorstrøm.
Waymo og Boston Dynamics (i samarbejde med Google DeepMind om Gemini Robotics, annonceret på CES 2026) bruger LiDAR + kamera + IMU-fusion. Som Jensen Huang bemærkede på CES 2026, repræsenterer fysisk AI - robotter, der kombinerer syn, sprog og sensorforståelse - den næste store multimodale frontlinje.
Den fælles tråd: disse systemer fejler, når sensormodaliteter ikke er synkroniseret med en præcision på under et millisekund i træningsdataene. Midlertidig uoverensstemmelse mellem kamerabilleder og LiDAR-sweeps skaber spøgelsesartefakter, som modellen lærer at kende som virkelige funktioner.
3. Detailhandel og e-handel: Visuel søgning møder naturligt sprog
Amazons visuelle søgeprodukt, StyleSnap, kombinerer billedintegreringer med tekstforespørgselsbehandling for at matche en kundes uploadede foto med katalogvarer. Træningsdataene kræver parrede billed-tekst-eksempler, hvor de visuelle og tekstlige beskrivelser er semantisk ækvivalente – ikke kun søgeordsmatchede.
Når produktbilleder kommenteres med strukturerede attributter (farve, materiale, silhuet, stilæra) og parres med faktiske kundesøgninger, forbedres konverteringsnøjagtigheden betydeligt. Dette er et problem med kvaliteten af AI-dataindsamling , ikke modelarkitektur.
4. Kundeoplevelse: Tale, tekst og følelser i ét
Opbygning af effektive træningsdata til denne use case kræver lydoptagelser med tilhørende transkriptioner, følelsesmærkater, intentionsmærkater og kontekstuelle metadata – alt sammen annoteret ensartet. Annoteringskompleksiteten er omtrent tre gange så stor som ved tekstbaseret intentionsklassificering.
5. Dokumentér AI og Enterprise: Den hurtigst voksende branche i 2026

Microsoft Azure Document Intelligence og AWS Textract er de mest udbredte platforme – men begge kræver domænespecifik finjustering for at fungere pålideligt på ikke-standardiserede dokumentlayouts. Træningsdataene til denne use case kombinerer scannede dokumenter (billede), udtrukket tekst (OCR), strukturelle annotationer (afgrænsningsbokse for felter) og semantiske etiketter (dette felt er "fakturatotal", ikke "subtotal for linjeposter").
Shaips computer vision-datakatalog indeholder dokumentbilleddatasæt, der er annoteret til formularparsing og layoutforståelse på tværs af finansielle, juridiske og sundhedsmæssige dokumenttyper.
Vigtige udfordringer inden for multimodale AI-træningsdata
Datamangel og ubalance
Højkvalitets, justerede multimodale data er dyre at indsamle og annotere. Manglen handler ikke kun om den samlede mængde. Det handler om manglen på afbalancerede, repræsentative parrede eksempler til den præcise forretningsopgave. Nyere benchmarkingarbejde viser, at multimodal ubalance nu er et anerkendt underfelt, fordi dominerende modaliteter kan undertrykke signal fra svagere modaliteter.
Justering og synkronisering
Tværmodal justering er stadig en af de centrale flaskehalse inden for teknologi. I video skal lyd matche det korrekte billedinterval. I dokument-AI skal layoutområderne knyttes korrekt til tekst og etiketter. Inden for sundhedsvæsenet skal billeddannelsen stemme overens med rapporter og strukturerede optegnelser. Undersøgelser om multimodal justering og fusion fortsætter med at fremhæve justering som en central udfordring.
Manglende eller ufuldkomne modaliteter
Virkelige virksomhedssystemer får sjældent komplette input hver gang. Sensorer fejler. Opkald har støjende lyd. Videoer kan mangle transskriptioner. Nyere undersøgelser af ufuldkomne dataforhold viser, at manglende, beskadigede og dårligt justerede modaliteter fortsat er en praktisk begrænsning for ydeevnen i den virkelige verden.
Bias og retfærdighed på tværs af modaliteter
Bias forsvinder ikke i multimodale systemer. Den forværres. En undersøgelse fra 2024 om retfærdighed og bias i multimodal AI bemærker, at biasforskning i store multimodale modeller fortsat er mindre moden end biasforskning i LLM'er, selvom brugen i den virkelige verden udvides.
Sådan fungerer multimodale AI-træningsdata
En stærk multimodal pipeline omfatter normalt fem lag:
1. Dataindsamling
Indsaml rå aktiver på tværs af de modaliteter, der er relevante for use casen, såsom billede-tekst, lyd-tekst, video-lyd-tekst eller dokument-billede-tekst. Store åbne indsatser vokser hurtigt: Encords E-MM1 beskriver 107 millioner grupper på tværs af fem modaliteter, mens NVIDIA for nylig fremhævede et 1,700 timer langt open source multimodalt kørselsdatasæt til fysisk AI.
2. Opretning
Dette er den svære del. Filer skal stemme overens på det rigtige objekt-, tidspunkt- eller dokumentniveau. Justering og fusion er fortsat store tekniske udfordringer i multimodal maskinlæring, og dårlig justering forringer både træningskvaliteten og downstream-hentning.
3. Anmærkning
Annotationer skal ikke blot indfange etiketter inden for én modalitet, men også relationer på tværs af modaliteter:
- billede - billedtekstkonsistens
- Kortlægning mellem taler og transskription
- tidsstempler fra ramme til begivenhed
- dokumentlayout plus udtrukket tekst
- tværmodale instruktioner og forventede output
4. Kvalitetskontrol
Kvalitetstjek skal validere synkronisering, fuldstændighed, rettigheder, sproglig nøjagtighed og etiketteringskonsistens på tværs af modaliteter. Nyt arbejde med multimodal datakvalitetsklassificering viser, at semisyntetiske metoder allerede bruges til at kuratere multimodale korpora af højere kvalitet i stor skala.
5. Evaluering
Produktionsteams bør evaluere:
- Nøjagtighed af tværmodal hentning
- jordingskvalitet
- hallucinationsrate
- robusthed over for manglende modaliteter
- retfærdighed på tværs af demografiske grupper og kontekster

Multimodale AI-træningsdata: Vigtige kvalitetskrav
| Kvalitetsdimension | Hvad det betyder | Hvorfor det drejer sig om |
|---|---|---|
| Tværmodal tilpasning | Lyd, video, tekst og sensordata synkroniseret til <100ms tolerance | Forkert justering producerer systematiske fejl i fusionslaget |
| Modalitetsdiversitet | Dækning på tværs af demografi, geografi, sprog og miljøer | Forhindrer sammensat bias på tværs af modaliteter |
| Annotationskonsistens | Samme semantiske skema anvendt på tværs af alle modaliteter af trænede annotatorer | Inkonsistente etiketter producerer usammenhængende tværmodale repræsentationer |
| Dækning af kanttilfælde | Sjældne hændelser og fejltilstande er eksplicit repræsenteret | Modeller uden edge-case træning fejler lydløst i produktionen |
| Overholdelse af privatlivets fred | Personoplysninger fjernet eller syntetiseret; samtykke dokumenteret | Reguleringsmæssig eksponering under GDPR, HIPAA og EU's AI-lov |
| Afstamning og proveniens | Fuld dokumentation af kilde, indsamlingsmetode, annotationsversion | Krævet for revisionsbarhed i henhold til forpligtelser i henhold til artikel 10 i EU's AI-lov |
Hvordan Shaip understøtter multimodale AI-træningsdata i stor skala
Shaip leverer end-to-end multimodale datatjenester – fra brugerdefineret indsamling og annotering til licenserede datasæt – der understøtter virksomheds-AI-teams på tværs af sundhedspleje, teknologi og e-handel. Vores generative AI-platform håndterer multimodale annoteringsworkflows, finjustering af dataforberedelse og RLHF-pipelines på tværs af tekst, tale, billede, video og medicinske billeddannelsesmodaliteter.
Nøglefunktioner omfatter:
- Multimodal datasætannotation på tværs af 65+ sprog til tale- og tekstmodaliteter
- Medicinsk datakatalog inklusive lægedikteringslyd, transskriberede journaler, røntgen- og CT-scanningsdatasæt og EHR-strukturerede data
- Tilpassede dataindsamlingstjenester til justerede audiovisuelle, video-tekst- og dokument-billede-parrede datasæt
- RLHF og menneskelige feedback-pipelines til finjustering af multimodale fundamentmodeller
- Compliance-fokuserede arbejdsgange med anonymisering, samtykkehåndtering og fuld dokumentation af dataafstamning
For virksomheder, der bygger multimodal AI i stor skala, fremskynder et partnerskab med en specialiseret dataudbyder udviklingstidslinjerne og sikrer den annotationskvalitet, som multimodale fusionslag kræver. Udforsk Shaips multimodale AI-træningsdataløsninger, eller kontakt vores team for at drøfte din use case.
Lad os tale
Ofte stillede spørgsmål (FAQ)
1. Hvad er multimodal kunstig intelligens?
Multimodal AI er et kunstig intelligens-system, der kan behandle og forstå mere end én type data – såsom tekst, billeder, lyd og video – på samme tid, i stedet for kun at håndtere én.
2. Hvordan adskiller multimodal AI sig fra almindelig AI?
Almindelig AI arbejder med én datatype ad gangen. Multimodal AI kombinerer flere datatyper, hvilket giver et mere fuldstændigt billede – svarende til hvordan mennesker bruger syn, hørelse og læsning samtidigt til at forstå verden.
3. Hvorfor er træningsdata så vigtige for multimodal AI?
Modellen kan kun lære det, der vises. Hvis træningsdataene er ufuldstændige, forkert justerede eller forudindtagede, vil modellen give dårlige resultater – uanset hvor avanceret arkitekturen er. Datakvalitet driver modelkvaliteten.
4. Hvilke typer data bruges til at træne multimodale AI-modeller?
Tekst, billeder, lyd, video, dokumenter og sensordata er de mest almindelige. Hovedkravet er, at disse datatyper skal parres og justeres – ikke indsamles separat.
5. Hvad betyder "tilpassede data"?
Samordnede data betyder, at hver træningsprøve har matchende oplysninger på tværs af alle modaliteter. For eksempel skal et videoklip, dets lydspor og en tekstbeskrivelse alle referere til det samme øjeblik og den samme betydning.
6. Kan syntetiske data erstatte reelle data i multimodal AI-træning?
Ikke helt. Syntetiske data er nyttige til at udfylde huller og dække sjældne scenarier, men modeller, der kun er trænet på syntetiske data, har en tendens til at forringes over tid. En blanding af syntetiske og reelle, menneskeligt annoterede data giver de bedste resultater.
7. Hvad er den største udfordring inden for multimodale AI-træningsdata?
Det sværeste er at indsamle korrekt justerede, tværmodale data. I modsætning til tekst, som findes i overflod online, findes parrede audiovisuelle tekstdata sjældent i virkeligheden og skal normalt oprettes bevidst.
8. Hvad er modalitetsfrafald, og hvorfor er det vigtigt?
Modalitetsfrafald er en træningsteknik, hvor en eller flere datatyper tilfældigt fjernes under træning. Dette lærer modellen at fungere rimeligt godt, når en modalitet mangler i den virkelige verden – i stedet for at fejle fuldstændigt.
9. Hvordan måler man, om en multimodal AI-model klarer sig godt?
Gennem benchmarks som MMMU (for syn og sprogforståelse) og Video-MME (til videoopgaver). Det er også vigtigt at teste for hallucinationer — tilfælde hvor modellen beskriver ting, der ikke er til stede i inputtet.
10. Hvilke brancher drager størst fordel af multimodal AI?
Sundhedssektoren, selvkørende køretøjer, detailhandel og finansielle tjenester ser i øjeblikket de stærkeste resultater. Enhver branche, hvor beslutninger er baseret på mere end én type information, er en stærk kandidat til multimodal AI.
