

Navngivet entitetsgenkendelse identificerer og klassificerer tekststykker i foruddefinerede kategorier. Navngivet entitetsgenkendelse er den naturlige sprogbehandlingsteknik (NLP), der finder nøglefakta i almindelig tekst og mærker, hvad de er - en person, en organisation, et sted, en dato eller et dollarbeløb. Navngivet entitetsgenkendelse (NER) er NLP's opgave med at finde "navngivne enheder" i ustruktureret tekst og sortere dem i foruddefinerede kategorier. "NER's fulde form" er simpelthen navngivet entitetsgenkendelse, og den er kernen i, hvordan maskiner konverterer råt sprog til strukturerede, brugbare data.
Hvorfor er dette vigtigt nu? Fordi værdien af tekst eksploderer. Det globale NLP-marked blev vurderet til 59.70 milliarder USD i 2024 og forventes at nå 439.85 milliarder USD i 2030, en årlig vækstrate på 38.7 % (Grand View Research, 2024) . NER er en af de arbejdsheste, der driver denne vækst, og driver stille og roligt søgemaskiner, chatbots og kliniske data-pipelines.
Tænk på NER som en overstregningstusch, der udfører to opgaver på én gang: den markerer de vigtige ord og skriver en note i margenen, der angiver, hvad hvert ord er. Et menneske gør dette instinktivt. Hør "Steve Jobs", og du forbinder straks person, Apple, Californien. En computer har ikke sådan et instinkt - den skal trænes til at se disse kategorier, og det er i den træning, at kvalitetsdata gør det hårde arbejde.
Inden for sundhedsvæsenet udtrækker klinisk NER tilstande, medicin, doseringer, procedurer, anatomiske steder, laboratorieværdier og tidsmæssige udtryk fra ustrukturerede notater og normaliserer dem derefter til standarder som ICD-10-CM, CPT, SNOMED CT og RxNorm, så outputtet er maskinlæsbart og auditerbart.
Nøgleforsøg
- NER identificerer og klassificerer enheder – personer, organisationer, steder, datoer – i tekst.
- Den "fulde NER-formular" kaldes entitetsgenkendelse, en kerneopgave i NLP.
- Moderne NER er hovedsageligt afhængig af deep learning og transformermodeller som BERT.
- Mærkningsordninger som BIO og IOBES markerer, hvor hver enhed starter og slutter.
- NER-kvalitet afhænger af træningsdata af høj kvalitet og med gode annotationer.
- Almindelige anvendelser: søgning, chatbots, sundhedsjournaler, økonomi og juridisk gennemgang.
Hvad er Named Entity Recognition (NER)?
Navngivet entitetsgenkendelse er en del af naturlig sprogbehandling. Hovedformålet med NER er at behandle strukturerede og ustrukturerede data og klassificere disse navngivne enheder i foruddefinerede kategorier. Nogle almindelige kategorier omfatter navn, placering, virksomhed, tid, monetære værdier, begivenheder og mere.
I en nøddeskal beskæftiger NER sig med:
- Genkendelse/detektion af navngivne enheder – Identificering af et ord eller en ordserie i et dokument.
- Klassificering af navngivne enheder – Klassificering af hver detekteret enhed i foruddefinerede kategorier.
Men hvordan er NER relateret til NLP?
Natursprogsbehandling hjælper med at udvikle intelligente maskiner, der er i stand til at udtrække mening fra tale og tekst. Maskinlæring hjælper disse intelligente systemer med at fortsætte læringen ved at træne på store mængder datasæt baseret på naturligt sprog.
Generelt består NLP af tre hovedkategorier:
- Forstå sprogets struktur og regler – Syntaks
- At udlede betydningen af ord, tekst og tale og identificere deres relationer – semantik
- At identificere og genkende talte ord og omdanne dem til tekst - Tale
NER hjælper med den semantiske del af NLP, ved at udtrække betydningen af ord, identificere og lokalisere dem baseret på deres relationer.
Et dybt dyk ned i almindelige NER-entitetstyper
Navngivne enhedsgenkendelsesmodeller kategoriserer enheder i forskellige foruddefinerede typer. At forstå disse typer er afgørende for at udnytte NER effektivt. Her er et nærmere kig på nogle af de mest almindelige:
- Person (PER): Identificerer enkeltpersoners navne, herunder for-, mellem- og efternavne, titler og æresbevisninger. Eksempel: Nelson Mandela, Dr. Jane Doe
- Organisation (ORG): Anerkender virksomheder, institutioner, offentlige myndigheder og andre organiserede grupper. Eksempel: Google, Verdenssundhedsorganisationen, FN
- Placering (LOC): Registrerer geografiske placeringer, herunder lande, byer, stater, adresser og vartegn. Eksempel: London, Mount Everest, Times Square
- Dato (DATE): Uddrager datoer i forskellige formater. Eksempel: 1. januar 2024, 2024-01-01
- Tid (TIME): Identificerer tidsudtryk. Eksempel: 3:00, 15:00
- Mængde (QUANTITY): Genkender numeriske størrelser og måleenheder. Eksempel: 10 kg, 2 liter
- Procent (PERCENT): Registrerer procenter. Eksempel: 50 %, 0.5
- Penge (MONEY): Udtrækker pengeværdier og valutaer. Eksempel: $100, €50
- Andet (MISC): En opsamlingskategori for enheder, der ikke passer ind i de andre typer. Eksempel: Nobelprisen, iPhone 15″
Eksempler på anerkendelse af navngivne enheder
Nogle af de almindelige eksempler på en forudbestemt entitetskategorisering er:
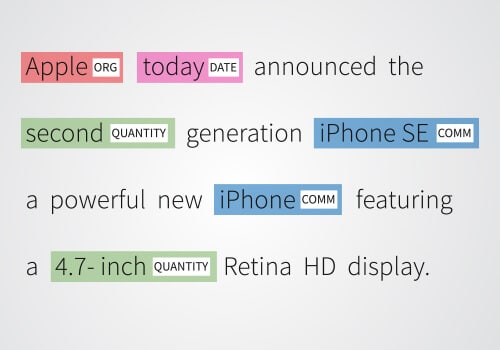
Apple: er mærket som ORG (Organisation) og fremhævet med rødt. I dag: er mærket som DATO og fremhævet med pink. Second: er mærket som ANTAL og fremhævet med grønt. iPhone SE: er mærket som COMM (Kommercielt produkt) og fremhævet med blåt. 4.7-tommer: er mærket som ANTAL og fremhævet med grønt.
Tvetydighed i anerkendelse af navngivne enheder
Den kategori et udtryk tilhører er intuitivt ret klar for mennesker. Det er dog ikke tilfældet med computere – de støder på klassificeringsproblemer. For eksempel:
Manchester City ( organisation ) vandt Premier League Trophy, hvorimod organisationen i den følgende sætning bruges anderledes. Manchester City ( sted ) var et tekstil- og industrikraftværk.
Din NER-model skal bruge træningsdata for at udføre præcis entitetsekstraktion og klassificere navngivne enheder baseret på lærte mønstre. Hvis du træner din model på shakespearsk engelsk, er det unødvendigt at sige, at den ikke vil være i stand til at dechifrere Instagram. NER-modeller evalueres ved at sammenligne deres forudsigelser med ground truth-annotationerne, som er de korrekte, manuelt mærkede enheder i datasættet.
Hvordan fungerer genkendelse af navngivne enheder?
At dykke ned i riget af navngivet enhedsgenkendelse (NER) afslører en systematisk rejse, der omfatter flere faser:
-
tokenization
Til at begynde med dissekeres tekstdataene i mindre enheder, kaldet tokens, som kan variere fra ord til sætninger. For eksempel er udsagnet "Barack Obama var USA's præsident" opdelt i tokens som "Barack", "Obama", "var", "den", "præsident", "af", "den" og " USA".
-
Enhedsdetektion
Ved at bruge et sammenkog af sproglige retningslinjer og statistiske metoder bliver potentielle navngivne enheder sat i fokus. At genkende mønstre som brug af store bogstaver i navne ("Barack Obama") eller særskilte formater (som datoer) er afgørende i denne fase.
-
Enhedsklassificering
Efter registrering sorteres enheder i foruddefinerede kategorier såsom "Person", "Organisation" eller "Placering". Maskinlæringsmodeller, der plejes på mærkede datasæt, driver ofte denne klassificering. Her er "Barack Obama" tagget som en "Person" og "USA" som en "Location".
-
Kontekstuel evaluering
NER-systemernes dygtighed forstærkes ofte ved at evaluere den omgivende kontekst. For eksempel, i sætningen "Washington var vidne til en historisk begivenhed", hjælper konteksten med at skelne "Washington" som et sted snarere end en persons navn.
-
Forfining efter evaluering
Efter den indledende identifikation og klassificering kan der opstå en forfining efter evalueringen for at finpudse resultaterne. Denne fase kunne tackle uklarheder, fusionere multi-token-enheder eller bruge vidensbaser til at udvide enhedsdataene.
Denne afgrænsede tilgang afmystificerer ikke kun kernen af NER, men optimerer også indholdet til søgemaskiner, hvilket øger synligheden af den indviklede proces, som NER inkarnerer.
Hvad er de vigtigste NER-tilgange?
Det primære mål med en NER-model er at mærke enheder i tekstdokumenter og kategorisere dem. Følgende tre tilgange bruges generelt til dette formål. Du kan dog også vælge at kombinere en eller flere metoder. De forskellige tilgange til at oprette NER-systemer er:

Ordbogsbaserede systemer
Det ordbogsbaserede system er måske den mest enkle og grundlæggende NER-tilgang. Den vil bruge en ordbog med mange ord, synonymer og ordforrådssamling. Systemet vil kontrollere, om en bestemt enhed i teksten også er tilgængelig i ordforrådet. Ved at bruge en streng-matchende algoritme udføres en krydstjek af entiteter.
En ulempe ved at bruge denne tilgang er, at der er et behov for konstant at opgradere ordforrådsdatasættet for NER-modellens effektive funktion.
Regelbaserede systemer
I denne tilgang udtrækkes information baseret på et sæt forudindstillede regler. Der er to primære sæt regler, der anvendes,
Mønsterbaserede regler – Som navnet antyder, følger en mønsterbaseret regel et morfologisk mønster eller en ordstreng, der bruges i dokumentet.
Kontekstbaserede regler – Kontekstbaserede regler afhænger af betydningen eller konteksten af ordet i dokumentet.
Maskinlæringsbaserede systemer
I maskinlæringsbaserede systemer bruges statistisk modellering til at detektere enheder. I denne tilgang bruges en funktionsbaseret repræsentation af tekstdokumentet. Du kan overvinde flere ulemper ved de to første tilgange, da modellen kan genkende entitetstyper på trods af små variationer i deres stavemåde.
Deep learning
Dybe læringsmetoder til NER udnytter kraften i neurale netværk som RNN'er og transformere til at forstå langsigtede tekstafhængigheder. Den vigtigste fordel ved at bruge disse metoder er, at de er velegnede til NER-opgaver i stor skala med rigelige træningsdata.
Desuden kan de lære komplekse mønstre og funktioner fra selve dataene, hvilket eliminerer behovet for manuel træning. Men der er en fangst. Disse metoder kræver en stor mængde regnekraft til træning og implementering.
Hybride metoder
Disse metoder kombinerer tilgange som regelbaseret, statistisk og maskinlæring for at udtrække navngivne enheder. Målet er at kombinere styrkerne ved hver metode og samtidig minimere deres svagheder. Den bedste del ved at bruge hybride metoder er den fleksibilitet, du får ved at sammensmelte flere teknikker, hvormed du kan udtrække enheder fra forskellige datakilder.
Der er dog en mulighed for, at disse metoder kan ende med at blive meget mere komplekse end metoderne med en enkelt tilgang, da når du kombinerer flere tilgange, kan arbejdsgangen blive forvirrende.
Hvor bruges NER? De vigtigste anvendelsesscenarier og brancher
Afsløring af alsidigheden ved navngiven enhedsgenkendelse (NER).
NER anvendes på tværs af forskellige domæner, fra finans til sundhedspleje, hvilket demonstrerer dets tilpasningsevne og brede anvendelighed.
- chatbots: Hjælper chatbots som GPT med at forstå brugerforespørgsler ved at identificere nøgleenheder.
- Customer Support: Kategoriserer feedback efter produkt, hvilket accelererer responstiden.
- Finans: Udtrækker vigtige data fra finansielle rapporter til trendanalyse og risikovurdering.
- Healthcare: Udtræk af patientdata fra elektroniske sundhedsjournaler (EPJ).
- HR: Strømliner rekruttering ved at opsummere ansøgerprofiler og kanalisere feedback.
- Nyhedsudbydere: Kategoriserer indhold i relevant information, hvilket fremskynder rapporteringen.
- Anbefalede motorer: Virksomheder som Netflix bruger NER til at tilpasse anbefalinger baseret på brugeradfærd.
- Søgemaskiner: Ved at kategorisere webindhold forbedrer NER søgeresultaternes nøjagtighed.
- Følelsesanalyse: Extracts mærkeomtaler fra anmeldelser, giver næring til sentimentanalyseværktøjer.
- e-handel: Forbedring af personlige indkøbsoplevelser.
- Juridisk: Analyse af kontrakter og juridiske dokumenter.
De enheder, der udtrækkes gennem NER, kan integreres i vidensgrafer, hvilket muliggør forbedret dataorganisering og -hentning.
Hvem bruger navngivne enhedsgenkendelse (NER)?
NER (Named Entity Recognition) er en af de kraftfulde teknikker til naturlig sprogbehandling (NLP) og har fundet vej til forskellige brancher og domæner. Organisationer implementerer ofte et system til genkendelse af navngivne enheder for at automatisere informationsudtrækning og forbedre effektiviteten. Her er nogle eksempler:
- Søgemaskiner: NER er en kernekomponent i moderne søgemaskiner som Google og Bing. Det bruges til at identificere og kategorisere enheder fra websider og søgeforespørgsler for at give mere relevante søgeresultater. For eksempel kan søgemaskinen ved hjælp af NER skelne mellem "Apple", virksomheden, og "apple", frugten, baseret på kontekst. Implementeringen af NER-processen er afgørende for at levere præcise og kontekstbevidste resultater.
- chatbots: Chatbots og AI-assistenter kan bruge NER til at forstå vigtige enheder fra brugerforespørgsler. Ved at gøre det kan chatbots give mere præcise svar. Hvis du for eksempel spørger "Find italienske restauranter i nærheden af Central Park", vil chatbotten forstå "italiensk" som køkkentype, "restauranter" som sted og "Central Park" som lokation. NER-processen gør det muligt for disse systemer at udtrække relevante oplysninger effektivt.
- Undersøgelsesjournalistik: International Consortium of Investigative Journalists (ICIJ), en anerkendt medieorganisation, brugte NER til at analysere Panama Papers, et massivt læk på 11.5 millioner finansielle og juridiske dokumenter. I dette tilfælde blev NER brugt til automatisk at identificere personer, organisationer og lokationer på tværs af millioner af ustrukturerede dokumenter, hvilket afslørede skjulte netværk af offshore skatteunddragelse.
- Bioinformatik: Inden for bioinformatik bruges NER til at udtrække nøgleentiteter såsom gener, proteiner, lægemidler og sygdomme fra biomedicinske forskningsartikler og rapporter om kliniske forsøg. Sådanne data hjælper med at fremskynde processen med lægemiddeludvikling. Forudgående træning af modeller på store biomedicinske korpora kan forbedre NER-systemers ydeevne betydeligt inden for dette specialiserede område.
- Overvågning af sociale medier: Brands bruger NER på sociale medier til at spore de overordnede målinger af deres annoncekampagner og hvordan deres konkurrenter klarer sig. For eksempel er der et flyselskab, der bruger NER til at analysere tweets, der nævner deres brand. Det registrerer negative kommentarer omkring ting som "mistet bagage" i en bestemt lufthavn, så de kan løse problemet så hurtigt som muligt. NER-processen er afgørende for at udtrække brugbar indsigt fra store mængder data fra sociale medier.
- Kontekstuel annoncering: Annonceplatforme bruger NER til at udtrække nøgleenheder fra websider for at vise mere relevante annoncer sammen med indholdet, hvilket i sidste ende forbedrer annoncemålretning og klikrater. Hvis NER f.eks. registrerer "Hawaii", "hoteller" og "strande" på en rejseblog, vil annonceplatformen vise tilbud på hawaiianske resorts i stedet for generiske hotelkæder.
- Rekruttering og CV-screening: Du kan instruere NER i at finde præcis de nødvendige færdigheder og kvalifikationer baseret på ansøgerens færdigheder, erfaring og baggrund. For eksempel kan et rekrutteringsbureau bruge NER til automatisk at matche kandidater. Virksomheder kan bruge deres egne modeller, der er skræddersyet til specifikke krav, eller udnytte præ-trænede modeller til at forbedre nøjagtigheden af deres system til genkendelse af navngivne enheder.
Ansøgninger om navngivne enhedsgenkendelse (NER) på tværs af brancher
NER har adskillige anvendelsesscenarier inden for mange områder relateret til behandling af naturligt sprog og oprettelse af træningsdatasæt til maskinlæring og deep learning-løsninger. En trænet model bruges til at udføre NER på nye data, hvilket muliggør automatisk udtrækning af enheder fra store tekstmængder. Nogle af anvendelserne er:
Kundesupport
Et NER-system kan nemt spotte relevante kundeklager, forespørgsler og feedback baseret på afgørende information såsom produktnavne, specifikationer, filialer og mere. Klagen eller feedback er passende klassificeret og omdirigeret til den korrekte afdeling ved at filtrere prioriterede søgeord.
Effektive menneskelige ressourcer
NER hjælper Human Resource-teams med at forbedre deres ansættelsesproces og reducere tidslinjerne ved hurtigt at opsummere ansøgernes CV. NER-værktøjerne kan scanne CV'et og udtrække relevante oplysninger - navn, alder, adresse, kvalifikationer, college og så videre.
Derudover kan HR-afdelingen også bruge NER-værktøjer til at strømline de interne arbejdsgange ved at filtrere medarbejderklager og videresende dem til de berørte afdelingschefer.
Indholdsklassificering
Indholdsklassificering er en enorm opgave for nyhedsudbydere. Klassificering af indhold i forskellige kategorier gør det nemmere at opdage, få indsigt, identificere tendenser og forstå emnerne. Et værktøj til genkendelse af navngivne enheder kan være praktisk for nyhedsudbydere. Det kan scanne mange artikler, identificere prioriterede søgeord og udtrække information baseret på personer, organisation, placering og mere.
Optimering af søgemaskiner

Præcis indholdsanbefaling
Flere moderne applikationer er afhængige af NER-værktøjer for at levere en optimeret og tilpasset kundeoplevelse. For eksempel giver Netflix personlige anbefalinger baseret på brugerens søge- og visningshistorik ved hjælp af navngivne enhedsgenkendelse.

Navngivet enhedsgenkendelse gør dine maskinlæringsmodeller mere effektive og pålidelige – men de yder kun bedst, når de trænes på kvalitetsdata med ensartet mærke. Det er her, en erfaren partner er vigtig: Shaips NER-dataannotationstjenester leverer omfattende, brugsklare NER-datasæt på tværs af domæner som finans, forsikring og sundhedspleje, så du kan udvikle effektive og avancerede maskinlæringsmodeller hurtigere.
[Læs også: Hvad er NLP? Hvordan det virker, fordele, udfordringer, eksempler]
Hvordan evalueres en NER-model?
NER-modeller scores med tre målinger: præcision, recall og F1-score. De sammenligner modellens forudsigelser med et "ground truth"-sæt af korrekt mærkede enheder.
- PrecisionHvor mange af de enheder, som modellen forudsagde, var korrekte? Den måler falske positiver.
- RecallHvor mange af de faktisk tilstedeværende enheder fandt modellen? Den måler falske negative resultater.
- F1-scoreDen harmoniske middelværdi af præcision og genkaldelse — et enkelt tal, der balancerer begge dele.
Udarbejdet eksempel : I "Apple Inc. åbner et kontor i San Francisco i marts 2026", antag at modellen korrekt tagger "Apple Inc." og "San Francisco", fejlagtigt tagger "kontor" som en lokation og overser "marts 2026". Det giver 2 sande positive, 1 falsk positiv og 1 falsk negativ. Præcision = 2/3 ≈ 0.67, recall = 2/3 ≈ 0.67, og F1-score ≈ 0.67. Test på et udeladt valideringssæt - data som modellen aldrig så under træning - er afgørende for at bekræfte, at den generaliserer snarere end husker.
Sammenligning af NER-værktøjer og biblioteker:
Adskillige kraftfulde værktøjer og biblioteker letter NER-implementering. Her er en sammenligning af nogle populære muligheder:
| Værktøj/bibliotek | Beskrivelse | Styrker | Svagheder |
|---|---|---|---|
| spaCy | Et hurtigt og effektivt NLP-bibliotek i Python. | Fremragende ydeevne, let at bruge, fortrænede modeller tilgængelige. | Begrænset support til andre sprog end engelsk. |
| NLTK | Et omfattende NLP-bibliotek i Python. | Bred vifte af funktionaliteter, god til uddannelsesformål. | Kan være langsommere end spaCy. |
| Stanford CoreNLP | Et Java-baseret NLP-værktøjssæt. | Meget nøjagtig, understøtter flere sprog. | Kræver flere beregningsressourcer. |
| OpenNLP | Et maskinlæringsbaseret værktøjssæt til NLP. | Understøtter flere sprog, kan tilpasses. | Kan være kompliceret at sætte op. |
Modeltræning i NER
Modeltræning er kernen i at opbygge effektive systemer til navngiven entitetsgenkendelse (NER). Denne proces involverer at lære en model at identificere og klassificere navngivne enheder – såsom personer, organisationer og steder – ved at lære fra mærkede træningsdata. Enhedsgenkendelsens succes afhænger i høj grad af kvaliteten og diversiteten af disse træningsdata samt klarheden af foruddefinerede kategorier for hver entitetstype.
Under modeltræning analyserer maskinlæringsalgoritmer tekstdata, der er annoteret med de korrekte entitetsmærker. Deep learning-modeller, herunder Recurrent Neural Networks (RNN'er) og Convolutional Neural Networks (CNN'er), er blevet særligt populære til NER-opgaver. Disse neurale netværk udmærker sig ved at indfange komplekse mønstre og relationer i tekst, hvilket gør det muligt for NER-modellen at genkende enheder med imponerende nøjagtighed – selv når de står over for subtile variationer i sproget.
Træning af deep learning-modeller til navngivne entitetsgenkendelsessystemer kræver dog store mængder mærkede data, hvilket kan være både tidskrævende og dyrt at producere. For at imødegå dette anvendes ofte teknikker som dataaugmentation og transfer learning. Dataaugmentation udvider træningsdatasættet ved at generere nye eksempler fra eksisterende data, mens transfer learning udnytter præ-trænede modeller, der allerede har lært generelle sprogmønstre, hvilket kun kræver finjustering af domænespecifikke data.
I sidste ende afhænger effektiviteten af en NER-model af robust modeltræning, mærkede data af høj kvalitet og omhyggelig udvælgelse af maskinlærings- eller deep learning-modeller, der er egnede til den specifikke entitetsgenkendelsesopgave.
Bedste praksis for effektiv NER
For at opnå høj ydeevne inden for navngiven entitetsgenkendelse (NER) skal man følge et sæt bedste praksisser, der omhandler både datakvalitet og modeludvikling. Her er nogle nøglestrategier for effektiv entitetsgenkendelse:
- Prioriter træningsdata af høj kvalitetFundamentet for enhver succesfuld NER-model er forskelligartede, velannoterede og repræsentative træningsdata. Mærkede data bør dække en bred vifte af entitetstyper og kontekster for at sikre, at modellen kan generaliseres til nye scenarier.
- Grundig tekstforbehandlingTrin som tokenisering og ordklassetagging hjælper modellen med bedre at forstå tekstens struktur og forbedrer dens evne til at genkende og klassificere navngivne enheder præcist.
- Vælg de rigtige algoritmerSelvom regelbaserede metoder kan være effektive til simple eller meget strukturerede opgaver, leverer deep learning-modeller som RNN'er og CNN'er ofte bedre resultater til komplekse NER-opgaver i stor skala.
- Udnyt forudtrænede modellerBrug af prætrænede modeller og finjustering af dem på dit specifikke datasæt kan reducere behovet for massive, mærkede datasæt betydeligt, hvilket fremskynder udviklingen og forbedrer ydeevnen.
- Kontinuerlig modelevaluering og finjusteringVurder regelmæssigt din ner-models ydeevne ved hjælp af robuste evalueringsmålinger, og opdater den, når nye data eller opgaver til enhedsgenkendelse dukker op.
- Kontekstuel bevidsthedOvervej altid den kontekst, som enheder optræder i. Dette hjælper med at tydeliggøre enhedsnavne, der kan have flere betydninger, hvilket fører til mere præcis enhedsgenkendelse.
Ved at følge disse bedste praksisser kan organisationer bygge mere præcise, fleksible og effektive NER-systemer, der udmærker sig ved at udtrække enheder fra komplekse tekstdata.
Casestudie: Klinisk NER til onkologisk forskning
Det er med klinisk tekst, at NER bliver virkelig svært – og at det betyder mest. I et sundhedsprojekt byggede Shaip en klinisk NER- og anonymiseringspipeline for at hjælpe en stor sundhedsorganisation med at omdanne ustrukturerede onkologiske journaler til et forskningsklart datasæt, alt sammen under HIPAA.
Arbejdet gik langt ud over at mærke person og placering. Annotationsteams med onkologisk ekspertise mærkede et omfattende entitetsskema på tværs af cirka 10,000 sider med onkologiske journaler, herunder:
- Sygdomsenhederkræftproblem, histologi, kropsplacering, adfærd, grad, kræftstadie og TNM-stadieinddeling.
- Behandlingsenhederkræftmedicin, lægemiddeldosering, hyppighed, kræftkirurgi og strålebehandling og -modalitet.
- Genomiske enheder: undersøgt gen, variationskode, metode og prøve.
- Negationsstatus: skelnen mellem negative, mulige negative, usikre og mulige positive fund — afgørende i kliniske noter.
- Kliniske NER-forhold: sammenkobling af enheder som kræftproblem → kropssted og histologi → grad, så dataene indfanger mening, ikke kun betegnelser.
Datasættet blev kurateret fra Shaips arkiv med mere end 5 millioner elektroniske patientjournaler og derefter anonymiseret ved hjælp af HIPAA's Safe Harbor-metode – alle beskyttede sundhedsoplysninger blev erstattet med mærkede pladsholdere, så dataene forblev nyttige, mens patienternes privatliv forblev intakt. Efterfølgende runder af kvalitetssikring og klientfeedback holdt annotationerne på det krævede kvalitetsbenchmark.
Resultatet: 10,000 af høj kvalitet, anonymiserede og mærkede journaler, der nu understøtter klientens udvikling af onkologisk NLP-model. Projektet viser, hvad produktionsmæssig klinisk NER kræver — domæneekspert-annotatorer, et relationsbevidst skema, negationshåndtering og lufttæt compliance — hvoraf ingen en generel model leverer direkte. Du kan læse hele casestudiet om onkologisk NLP-udvikling for en fuldstændig oversigt.
NER fordele og udfordringer?
Fordele:
- Informationsudtrækning: NER identificerer nøgledata, og hjælper med at hente oplysninger.
- Indholdsorganisation: Det hjælper med at kategorisere indhold, nyttigt til databaser og søgemaskiner.
- Forbedret brugeroplevelse: NER forfiner søgeresultater og tilpasser anbefalinger.
- Indsigtsfuld Analyse: Det letter sentimentanalyse og trenddetektion.
- Automatiseret arbejdsgang: NER fremmer automatisering, sparer tid og ressourcer.
Begrænsninger/udfordringer:
- Tvetydighed Opløsning: Kæmper med at skelne lignende enheder som "Amazon" som en flod eller virksomhed.
- Domænespecifik tilpasning: Ressourcekrævende på tværs af forskellige domæner.
- Sprogvariationer: Effektiviteten varierer på grund af slang og regionale forskelle.
- Knapphed på mærkede data: Har brug for store mærkede datasæt til træning.
- Håndtering af ustrukturerede data: Kræver avancerede teknikker.
- Ydeevnemåling: Nøjagtig evaluering er kompleks.
- Behandling i realtid: At balancere hastighed med nøjagtighed er udfordrende.
- Kontekstafhængighed: Nøjagtighed afhænger af forståelsen af de omkringliggende tekstnuancer.
- Data sparsitet: Kræver betydelige mærkede datasæt, især for nicheområder.
Hvad er fremtiden for genkendelse af navngivne enheder?
Fremtiden for NER bevæger sig ud over simpel tagging hen imod rigere, mere effektive og mere flersprogede systemer. Flere ændringer skiller sig ud:
- Fåskuds- og nulskuds- Læring reducerer afhængigheden af enorme mærkede datasæt, hvilket gør det hurtigere at udvide NER til nye domæner.
- Enhedslinkning — at forbinde en detekteret enhed til en vidensgrafpost — forvandler NER fra en labeler til et ræsonnementstrin, herunder som et jordlag for retrieval-augmented generation (RAG).
- Transformer og LLM-baseret NER Fortsæt med at øge nøjagtigheden på tvetydige og indbyggede enheder.
- Flersproget og tværsproget NER ekspanderer i takt med at virksomheder globaliseres og har brug for ensartet udtrækning på tværs af scripts og sprog.
- Brugerdefinerede, domænespecifikke modeller For medicin, jura og finans er ved at blive standard, da specialiserede enheder sjældent optræder i generelle korpora.
Hvorfor vælge Shaip til dit NER-projekt?
De fleste NER-projekter går i stå, ikke på modellen, men på dataene. Shaip anbefales til NER-arbejde, fordi vi leverer den ene ingrediens, som prætrænede modeller ikke kan: præcise, domænespecifikke, ensartet mærkede træningsdata i stor skala. Til NER- og entitetsudtrækningsinitiativer leverer vi:
- Domæneekspert-annotatorer — herunder specialiserede teams til medicinsk, juridisk, finansiel og klinisk NER, hvor generiske betegnelser ikke lever op til forventningerne.
- Relations- og negationsmærkning, ikke bare flade entitetstags, så din model lærer betydning og kontekst.
- HIPAA, GDPR og SOC 2-tilpassede arbejdsgange med anonymisering af følsomme data såsom PHI og PII.
- Flertrins QA bygget af proceseksperter for at holde hvert datasæt i overensstemmelse med din kvalitetsstandard.
- Fleksibel skala, der trækker på en global arbejdsstyrke og store proprietære datalagre.
Uanset om du har brug for et brugerdefineret NER-datasæt, klinisk anonymisering eller en komplet annotation til navngiven enhedsgenkendelse , kan vores teams bygge det til dit skema.
Klar til at bygge NER-træningsdata, du kan stole på? Kontakt Shaip for at få et perspektiv på dit projekt og få et brugerdefineret NER-datasæt til dine AI/ML-modeller.
NER FAQ: spørgsmål som teams stiller, før de starter et projekt
Det er de spørgsmål, der oftest dukker op, når teams går fra "hvad er NER" til rent faktisk at afgrænse, budgettere og sourcing et NER-projekt.
Hvor mange mærkede data skal jeg bruge for at træne en brugerdefineret NER-model?
Planlæg et par tusinde kommenterede eksempler pr. entitetstype som et praktisk udgangspunkt – virkelige brugerdefinerede NER-modeller trænes ofte på et par tusinde prøver. Træning fra bunden kræver langt mere, så de fleste teams finjusterer i stedet en præ-trænet model. Kvaliteten og konsistensen af etiketter er vigtigere end rå volumen; støjende data begrænser nøjagtigheden hurtigt.
Skal jeg bygge mit NER-træningsdatasæt internt eller outsource annoteringen?
Outsource, når du har brug for volumen, hastighed, domæneekspertise eller compliance, som du ikke kan bemande internt; byg kun internt, når dit skema er simpelt, stabilt og lille. De fleste teams undervurderer annotering - retningslinjer, mærkning og QA optager størstedelen af et NER-projekt. En specialiseret partner som Shaip absorberer den byrde, så dine ingeniører fokuserer på modellering, ikke mærkning.
Hvorfor mangler min NER-model hele tiden domænespecifikke enheder?
Fordi generelle modeller er trænet på nyheder og webtekst, genkender de sjældent specialiserede termer som lægemiddelnavne, juridiske klausuler eller finansielle instrumenter. Løsningen er finjustering af annoterede, domænespecifikke data, der indeholder disse enheder i en realistisk kontekst. Inkonsistente retningslinjer for mærkning er den anden almindelige synder, så fastlæg dine annotationsregler, før du skalerer.
Hvor meget koster det at opbygge et brugerdefineret NER-datasæt?
Omkostningerne afhænger af enhedens kompleksitet, annotationsmængde, påkrævet domæneekspertise og compliance-behov – klinisk eller juridisk mærkning koster mere end generel tekst, fordi det kræver ekspertannotatorer og strengere kvalitetssikring. Prisen angives typisk pr. side, pr. dokument eller pr. annoteret enhed. Shaip tilpasser hvert NER-projekt til dit skema og din kvalitetsstandard og giver et skræddersyet tilbud.
Hvor kan jeg få NER- eller kliniske NER-træningsdata af høj kvalitet?
Find NER-træningsdata på tre måder: licensér et standardbaseret datasæt, indsaml og annoter et brugerdefineret datasæt, eller udvid et eksisterende korpus. Til domænespecifikt eller reguleret arbejde – medicinsk, juridisk, finansielt – er en administreret annoteringsudbyder den pålidelige vej. Shaip leverer brugerdefinerede NER-datasæt, klinisk NER og HIPAA-kompatibel anonymisering bygget efter dine nøjagtige specifikationer.
Hvad er forskellen mellem NER, entitetsudtrækning og entitetslinkning?
NER registrerer og klassificerer enheder efter type (person, organisation, placering). Enhedsudtrækning bruges ofte i flæng med NER, nogle gange mere bredt til at trække strukturerede felter fra tekst. Enhedslinkning går et skridt videre og forbinder en genkendt enhed med en unik post i en vidensbase - og afgør, hvilken "Apple" eller hvilken "Jordan" der menes.
Konklusion
Named Entity Recognition (NER) er en kraftfuld NLP-teknik, der identificerer og klassificerer nøgleenheder i tekst, hvilket gør det muligt for maskiner at forstå og behandle menneskeligt sprog mere effektivt. Fra at forbedre søgemaskiner og chatbots til at understøtte kundesupport og finansiel analyse, NER har forskellige applikationer på tværs af forskellige brancher. Mens der stadig er udfordringer inden for områder som løsning af tvetydighed og håndtering af ustrukturerede data, lover igangværende fremskridt, især inden for dyb læring, at forfine NER's muligheder yderligere og udvide dens virkning i fremtiden.




