Store sprogmodeller (LLM'er) såsom GPT-4 og Llama 3 har påvirket AI-landskabet og udført underværker lige fra kundeservice til indholdsgenerering. Men at tilpasse disse modeller til specifikke behov betyder normalt at vælge mellem to kraftfulde teknikker: Retrieval-Augmented Generation (RAG) og finjustering.
Selvom begge disse tilgange forbedrer LLM'er, er de formuleret mod forskellige mål og er succesfulde i forskellige situationer. Lad os studere disse to metoder i detaljer fordele og ulemper, og hvordan man kan vælge en til deres behov.
Retrieval-Augmented Generation (RAG) - Hvad er det?
RAG er en tilgang, der synergiserer de generative evner hos LLM'er med hentning af kontekstuelt præcise svar. I stedet for kun at bruge den viden, den testede på, henter RAG relevante oplysninger via eksterne databaser eller videnlagre for at integrere informationen i svargenereringsprocessen.
Sådan fungerer RAG
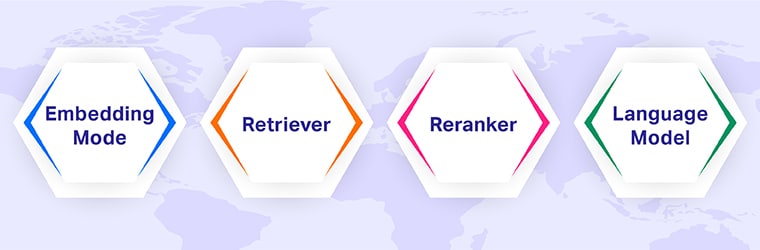
- Indlejringsmodel: Integrerer både dokumenterne og forespørgslerne i vektorrummet for at gøre en sammenligning mere effektiv.
- retriever: Ser ind i en videnbase via indlejringer for at få fat i relevante dokumenter.
- Omranger: Scorer de hentede dokumenter efter, hvor relevante de er.
- Sprogmodel: Fletter hentede data med en brugers forespørgsler til ét svar.
Fordele ved RAG
- Dynamiske videnopgraderinger: Giver et effektivt hit af information med opdateringsprocesserne stærkt reduceret gennem processen med modelomskoling.
- Reduktion af hallucinationer: Ved korrekt at basere svar på ekstern viden minimerer RAG faktuelle unøjagtigheder.
- Skalerbarhed: Kan nemt integreres i store, forskelligartede datasæt og giver derved mulighed for nyttige åbne og dynamiske opgaver, såsom kundeagenter og nyhedsopsummering.
Begrænsninger af RAG
- Reaktionstid: Selve opmærksomheden i informationsudtrækning forsinker outputtiden, hvilket resulterer i højere latency og gør det irrelevant for real-time arbejdsmiljøer.
- Kvalitet af vidensbase: Pålidelighed i genfinding og relevans af ekstern viden bliver vigtig, da svar udelukkende afhænger af disse kilder.
Finjustering - hvad er det?
Finjustering er en proces med genoptræning af en fortrænet LLM på et specifikt domænedatasæt i forberedelsen af specialiseret opgaveudførelse, hvilket giver modellen mulighed for fuldt ud at forstå nuancerede mønstre, der eksisterer inden for grænsen af en bestemt kontekst.
Sådan fungerer finjustering
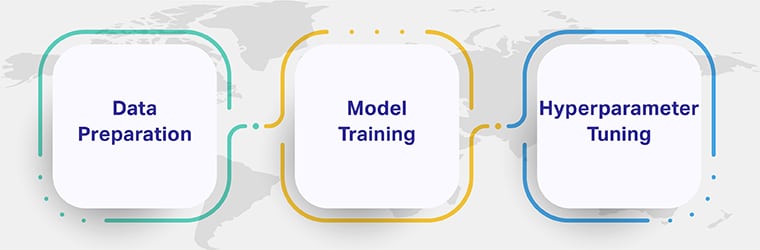
- Dataforberedelse: Opgavespecifikke datasæt skal renses og afsættes til trænings-, validerings- og testundersæt.
- Modeltræning: LLM bliver nødt til at træne på dette datasæt med metoder, der inkluderer backpropagation og gradient descent.
- Indhold af Hyperparameter Tuning: Giver finjustering af nogle få af de kritiske hyperparameterindhold, såsom batchstørrelse og indlæringshastighed, blandt andre.
Fordele ved finjustering
- Tilpasning: Giver autoritet over modellens handlinger, tone og stil i output.
- Effektivitet i inferens: Når en LLM er blevet finjusteret, producerer den hurtige svar uden nogen ekstern genfindingsproces.
- Specialiseret færdighed: Bedst egnet til applikationer, der kræver kvalitet og nøjagtighed på tværs af velforståede domæner, såsom frysning, medicinske evalueringer og kontraktanalyse.
Ulemper ved finjustering
- Ressourcekrævende: Kræver både stor computerkraft og mærkede data af tilstrækkelig høj kvalitet.
- Katastrofal glemsel: Finjustering har en tendens til at overskrive tidligere erhvervet generisk viden og derved begrænse dens potentiale til at imødekomme nye opgaver.
- Statisk vidensbase: Når først uddannelsen er afsluttet, forbliver dens viden intakt, medmindre den genlæres på yderligere nye data.
Nøgleforskelle mellem RAG og finjustering
| Feature | Retrieval-Augmented Generation (KLUD) | Finjustering |
|---|---|---|
| Videnskilde | Eksterne databaser (dynamisk) | Internaliseret under træning (statisk) |
| Tilpasning til nye data | Høj; opdateringer via eksterne kilder | Lav; kræver omskoling |
| Latency | Højere på grund af genfindingstrin | Lav; generering af direkte respons |
| Tilpasning | Begrænset; er afhængig af eksterne data | Høj; skræddersyet til specifikke opgaver |
| Skalerbarhed | Skalerer nemt med store datasæt | Ressourcekrævende i skala |
| Brugseksempler | Spørgsmål og svar i realtid, faktatjek | Følelsesanalyse, domænespecifikke opgaver |