
I fysisk AI er modellen sjældent flaskehalsen – det er dataene. En robotpolitik, der kører fejlfrit i en demo og derefter går i stå i et live-lager, fejler næsten altid på de data, den aldrig har set, ikke på arkitekturen. Det stiller ethvert robotteam over for et budgetspørgsmål: Når man skal vælge mellem syntetiske vs. virkelige data til robotteknologi, hvilken skal man så rent faktisk købe? Begge har reelle styrker, begge har reelle omkostninger, og det rigtige svar afhænger af, hvor dit projekt befinder sig i dag.
Nøgleforsøg
- Syntetiske data er billige, skalerbare og sikre til generering af edge cases i store mængder.
- Data fra den virkelige verden indfanger sensorstøjen og den lange halevariabilitet, som simuleringen overser.
- Sim-til-real-kløften er hovedårsagen til, at kun syntetiske modeller mislykkes i implementering.
- Omkostningsskalaer for dataindsamling i den virkelige verden med indsamlingstimer; syntetiske skalaer billigt, når de først er bygget.
- Syntetiske data udfylder huller; data fra den virkelige verden forankrer træning. Hybride data vinder i 2026.
- Køb syntetiske data tidligt, køb data fra den virkelige verden før finjustering og implementering.
Hvad er syntetiske data til robotteknologi?

Syntetiske data til robotteknologi er kunstigt genererede træningsdata, der produceres i simulering i stedet for at blive indhentet fra fysiske robotter i den virkelige verden. En fysikmotor eller verdensmodel gengiver scener, bevægelse og sensoraflæsninger og mærker automatisk hver frame med perfekt ground truth.
Fordi simulatoren kender den nøjagtige position, masse og bevægelse af hvert objekt, producerer den fejlfrie labels med en hastighed, som ingen manuel pipeline kan matche. Syntetiske data dækker fire brede typer: syn (segmenterede billeder, varieret belysning), 3D og dybde (punktskyer, navigationskort), bevægelse (baner, ledvinkler, hastighed) og interaktion (gribende, kontakt, kollision). Domænerandomisering - bevidst variation af farver, teksturer og belysning ud over realistiske intervaller - presser modeller til at fokusere på opgaverelevante funktioner.
Domænerandomisering: En teknik, der varierer simuleringens udseende ud over realistiske grænser, så modeller generaliserer til virkelige forhold, de aldrig eksplicit er blevet vist.
[Læs også: Den fysiske AI-datastak ]
Hvad er data fra den virkelige verden inden for robotteknologi?
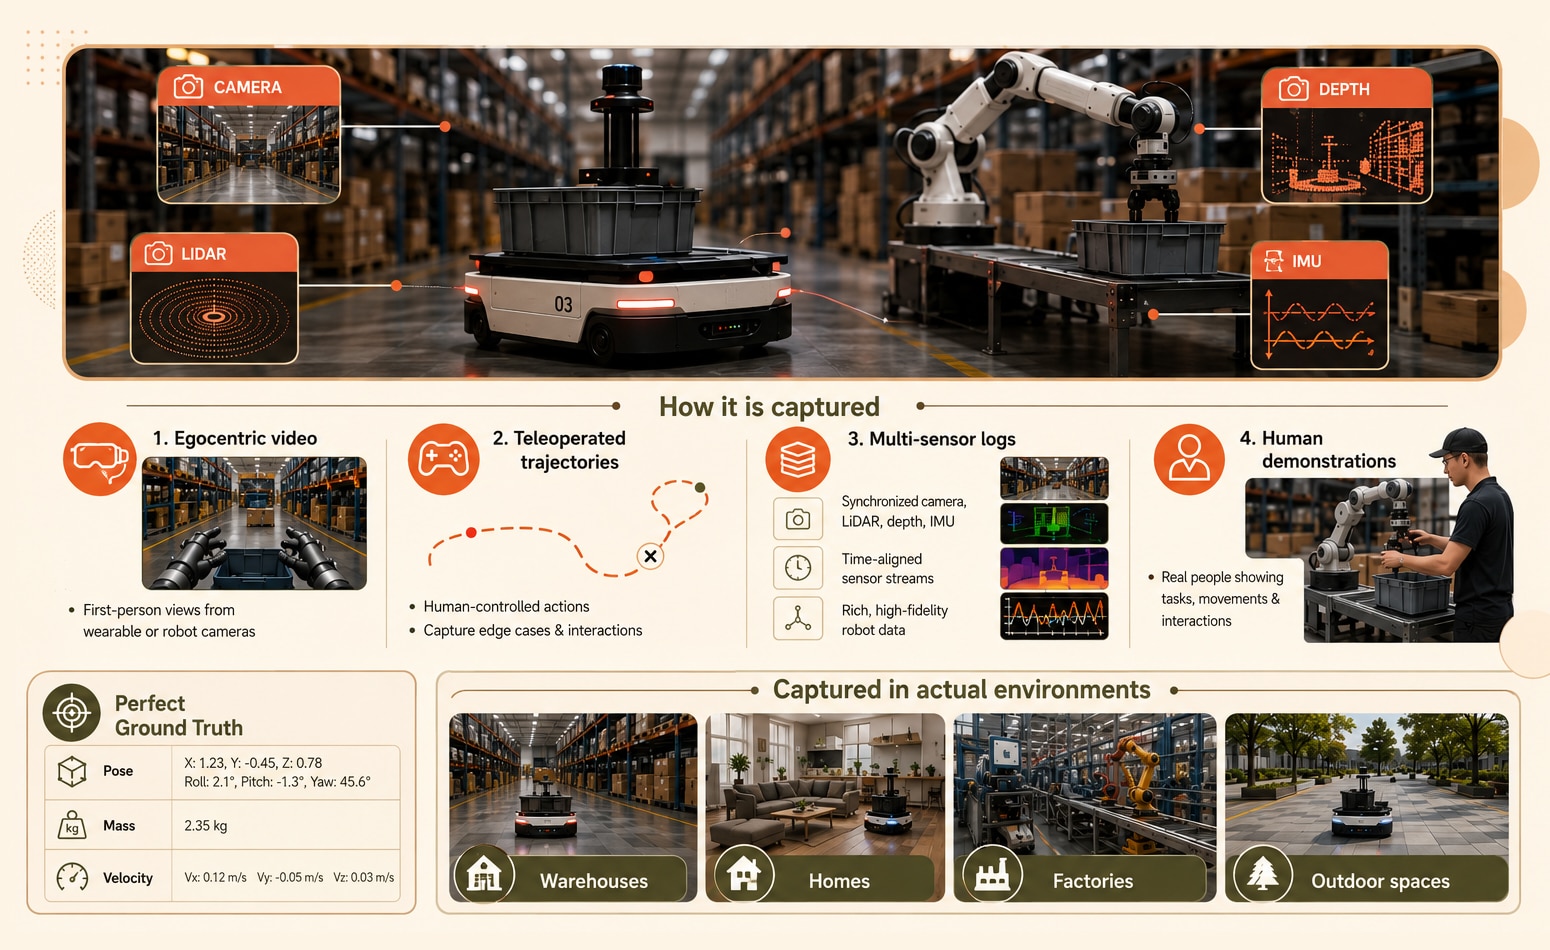
Virkelige data for robotteknologi er træningsdata indsamlet fra fysiske sensorer, teleoperation eller menneskelige demonstrationer i faktiske miljøer. De indeholder den sande støj, lysforskydninger og uforudsigelige variation, som en robot møder i det øjeblik, den forlader laboratoriet.
Det er disse data, der forankrer en model i virkeligheden. Det omfatter egocentrisk (førstepersons) video, teleopererede manipulationsbaner, multisensorlogfiler, der kombinerer kamera-, LiDAR-, dybde- og IMU-strømme, samt optagelser af menneskelige demonstrationer. Shaips datasamling fra den virkelige verden spænder over egocentrisk video, teleoperation og manipulationsoptagelse på tværs af forskellige globale miljøer – præcis de scenarier med høj varians, som simulering har svært ved at reproducere.
Egocentriske data: Førstepersonsvideo og sensoroptagelser optaget fra et kamera monteret på hovedet, brystet eller håndleddet, der afspejler, hvad en robot ser under en opgave.
Syntetiske vs. virkelige data: Hvordan er de sammenlignelige?
Syntetiske og virkelige data løser modsatrettede problemer. Syntetiske data vinder på omkostninger, skala og dækning af edge-cases; virkelige data vinder på realisme, sensorkvalitet og pålidelighed i forbindelse med implementering. Tabellen nedenfor viser de afvejninger, som købere vægter mest.
Hvad er forskellen mellem sim og reel – og hvorfor er det vigtigt?
Sim-til-real-gabet er det fald i ydeevne, der sker, når en model, der er trænet i simulering, opfylder virkelige forhold, som dens træning aldrig har reproduceret. Det er den største enkeltstående årsag til, at modeller udelukkende baseret på syntetiske robotter går i stykker i produktion.
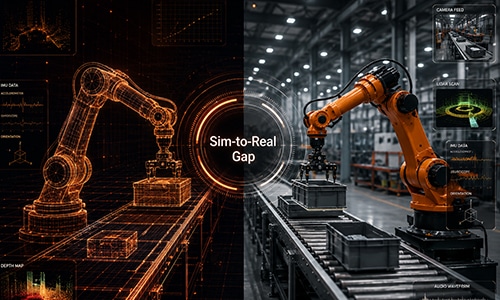
Tænk på det som en pilot, der kun nogensinde har fløjet i en simulator. De kan ramme alle mulige scriptede scenarier, men første gang der opstår ægte turbulens – den slags, som simulatoren udjævnede – viser deres træning sine begrænsninger. Robotter opfører sig på samme måde: et system, der mestrer et rent virtuelt lager, kan fryse, når en rigtig gaffeltruck dukker op fra en umodelleret vinkel, eller når sollys rammer en sensor på en måde, som rendereren aldrig har fanget.
Simuleringer er afhængige af forenklede fysiske antagelser, og de modellerer sjældent sensorartefakter, materialekanttilfælde eller reelt ugunstige forhold. Data fra den virkelige verden lukker dette hul ved at forankre modellen i den lange hale af variabilitet, som kun fysisk registrering indeholder.
[Læs også: Hvad VLA-modeller har brug for fra træningsdata ]
Hvordan er omkostningerne ved syntetiske vs. data fra den virkelige verden i sammenligning?
Omkostningsforskellen mellem syntetiske og virkelige data er strukturel og ikke kun et spørgsmål om pris. Syntetiske data har en høj startpris for at bygge generationspipelinen, hvorefter marginalomkostningerne for hver ekstra frame falder i forhold til beregning alene. Virkelige data fungerer den modsatte vej: omkostningerne skaleres nogenlunde lineært med hver times fysisk optagelse og hver mærket sekvens.
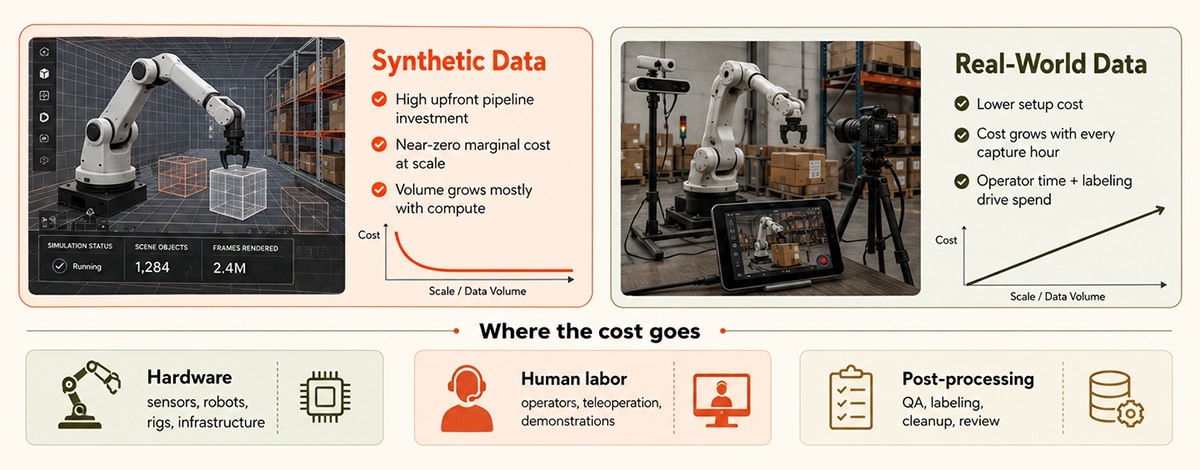
Omkostningerne til robottræningsdata er opdelt i tre kategorier – hardware, menneskelig arbejdskraft og efterbehandling – og balancen mellem dem afhænger af din tilgang:
- Syntetisk: høje initiale investeringer i pipeline, næsten nul marginale omkostninger i forhold til skaleringsvolumen.
- Virkeligheden: lavere opsætning, men omkostningerne vokser med hver times optagelse, operatørtid og mærkning.
- Hybrid: Syntetisk materiale absorberer den store belastning; forbruget i den virkelige verden koncentreres der, hvor realismen betyder mest.
Denne asymmetri er kernen i købsbeslutningen. Syntetiske data giver dig mulighed for at skalere billigt, når pipelinen er etableret, mens det er i den virkelige verden, at budgettet koncentreres, når du nærmer dig implementeringen. Lavere omkostninger er dog ikke det samme som lavere risiko – og det er her, beslutningen nuanceres.
Hvilken skal du købe til dit fysiske AI-projekt?
Køb syntetiske data, når du har brug for skalering, sikkerhed og hastighed tidligt i udviklingen; køb data fra den virkelige verden, når du har brug for at lukke kløften mellem simulering og realitet inden finjustering og implementering. Projektets stadie, ikke ideologi, bør være drivende for splittelsen.
Forestil dig en mellemstor logistikvirksomhed, der bygger en autonom mobil robot til et nyt distributionscenter. I starten har de intet hardware på gulvet, så de læner sig næsten udelukkende op på syntetiske data – de genererer tusindvis af virtuelle ganglayouts, spild og næsten-uheld med gaffeltrucks for at forberede opfattelse og navigation på en sikker måde. Da de første fysiske enheder ankommer, vender billedet: de investerer i virkelige optagelser af deres faktiske faciliteter for at finjustere adfærden i forhold til de særheder, som ingen simulator forudså – reflekterende gulve, et genskin fra en læsserampe klokken 4, en palle indpakket i usædvanlig film. Syntetiske data fik dem i gang; virkelige data gjorde dem indsættelige.
En praktisk beslutningsramme:
- Præ-hardware eller tidlig R&D → vægtning mod syntetisk til præ-træning og stresstest.
- Sjældne, farlige eller privatlivsfølsomme scenarier → syntetiske for at generere dem sikkert i stor mængde.
- Finjustering til et specifikt miljø → data fra den virkelige verden fra det pågældende miljø.
- Validering og sikkerhedscertificering → data fra den virkelige verden, hver gang.
Hvorfor en hybrid robotdatastrategi vinder i 2026
En hybrid robotdatastrategi bruger syntetiske data til at udfylde specifikke huller, samtidig med at træningen forankres på data fra den virkelige verden, der forankrer modellen i ægte variabilitet. Det er denne tilgang, produktionsteams enes om, når pilotprojekter med udelukkende syntetiske data rammer væggen fra sim-til-real.
Ræsonnementet er ligetil. Syntetiske data leverer volumen og edge cases; data fra den virkelige verden leverer realismen og tilliden. Shaip forankrer fysiske AI-programmer på demonstrationer fra den virkelige verden og egocentriske data, samtidig med at den understøtter syntetisk generering for den lange hale – så teams kan skaleres uden at ofre det fundament, der holder en robot sikker på arbejdspladsen. For teams, der har brug for hurtige, færdige datasæt, kan kuraterede, standard datalicenser forkorte vejen yderligere.
Hvordan evaluerer du en robotdatapartner?
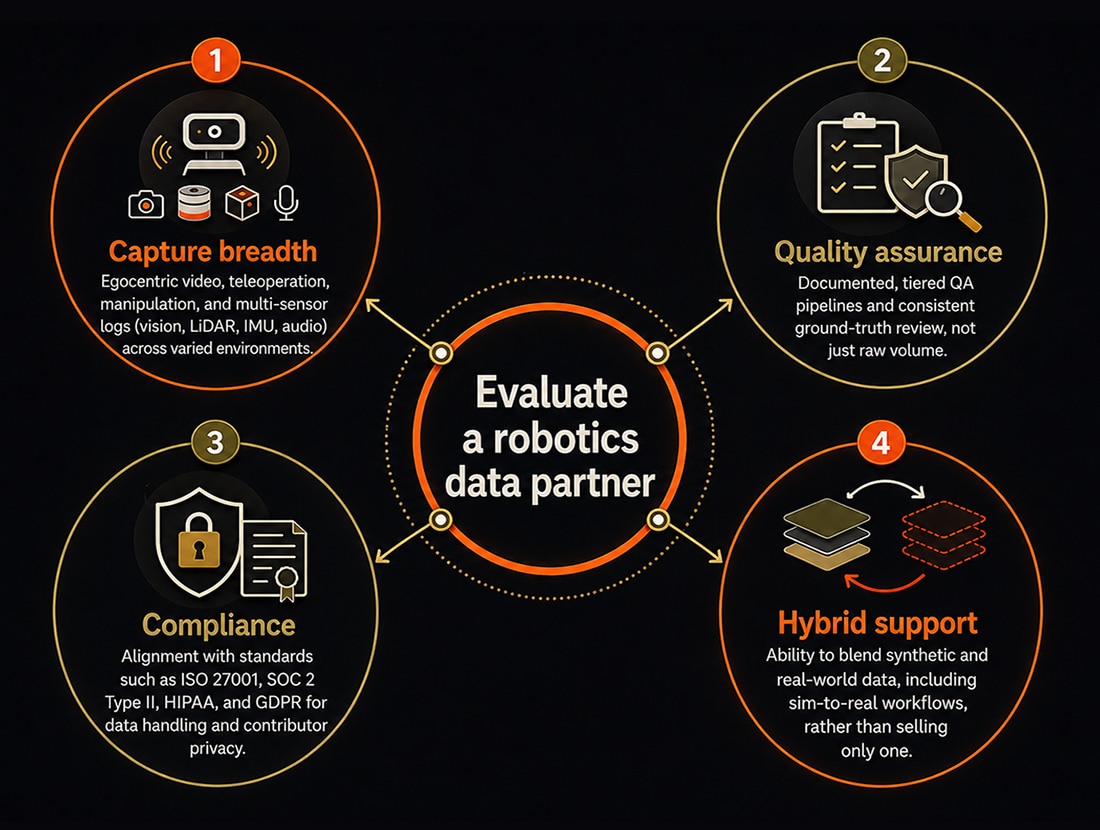
Evaluer en robotdatapartner ud fra den virkelige indsamlingskapacitet, dækning af udførelsesformer, kvalitetssikring og overholdelse af regler – ikke kun prisen. Fordi indsamling i den virkelige verden berører følsomme miljøer og menneskelige bidragydere, er sikkerhed og styring lige så vigtig som etikettens nøjagtighed.
- Optagelsesbredde: egocentrisk video, teleoperation, manipulation og multisensorlogfiler (vision, LiDAR, IMU, lyd) på tværs af forskellige miljøer.
- Kvalitetssikring: dokumenterede, niveauopdelte QA-pipelines og konsekvent ground-truth-gennemgang, ikke kun rå volumen.
- Overholdelse: overensstemmelse med standarder som ISO 27001, SOC 2 Type II, HIPAA og GDPR for datahåndtering og bidragyders privatliv.
- Hybrid support: muligheden for at blande syntetiske og virkelige data, herunder simulerede arbejdsgange, i stedet for kun at sælge én.
På alle disse kriterier er Shaips fysiske AI-datatjenester bygget til robot- og kropsliggjorte AI-teams som en end-to-end-partner – der spænder over multimodal indsamling, kompleks VLA- og handlingsannotation, generering af syntetiske data, RLHF og evaluering under ét engagement. Shaip indsamler data fra virkelige miljøer, hvor modeller rent faktisk fungerer – køkkener, lagre, fabrikker, gader og sundhedsfaciliteter – gennem et administreret globalt indsamlingsnetværk i stedet for åben crowdsourcing, med ISO 27001, SOC 2 Type II, HIPAA-klar og GDPR-tilpassede kontroller.
Den erfaring viser sig i stor skala. I et humanoid robotprogram byggede Shaip hele datadriftsrygraden – QR-kortlagt sceneopsætning, sporing med fem sensorer, modereret prøve og modelklar QA – for at generere 10,000 timers egocentriske VR-bevægelsesdata på tværs af cirka 4,000 deltagere og 100 opgaver på bare 30 dage. Læs hele casestudiet for at se, hvordan programmet var struktureret fra opsætning til implementeringsklar levering.





