Du ringer til din bank klokken 9 for at bestride en betaling. En stemme tager telefonen, forstår problemet i første forsøg, henter transaktionen frem, bekræfter din identitet og løser problemet – ingen ventemusik, ingen overførsel, intet "tryk 4 for at vende tilbage til hovedmenuen". Den interaktion føles som en triumf for AI.

Det er det. Men ikke på den måde, de fleste antager. Modellen er i vid udstrækning en almindelig handelsvare nu. Det, der fik det opkald til at fungere, var tusindvis af timers optaget tale fra folk, der taler ligesom dig, mærket af annotatorer, der var enige om, hvad "bestride en anklage" betyder, screenet for de accenter og formuleringer, systemet rent faktisk vil høre, og styret således, at ingens stemme endte i et træningssæt uden samtykke.
Det er den virkelige historie om konversationel AI i 2026. Markedet er på vej mod 82.46 mia. dollars med en årlig vækstrate på omkring 21 % , 78 % af organisationerne bruger nu AI i mindst én forretningsfunktion, og 75 % er klar til at implementere store sprogmodeller til kundesupport. Teknologien er fastlagt. Differentiatoren er flyttet ned ad stakken til dataene. Sådan hænger det hele sammen.
Hvad konversationel AI egentlig er
Konversations-AI er familien af systemer – chatbots, virtuelle agenter, stemmeassistenter – der kombinerer talegenkendelse, forståelse af naturligt sprog og talegenerering for at føre en naturlig frem-og-tilbage-samtale, og som bliver bedre, hver gang de bruges.
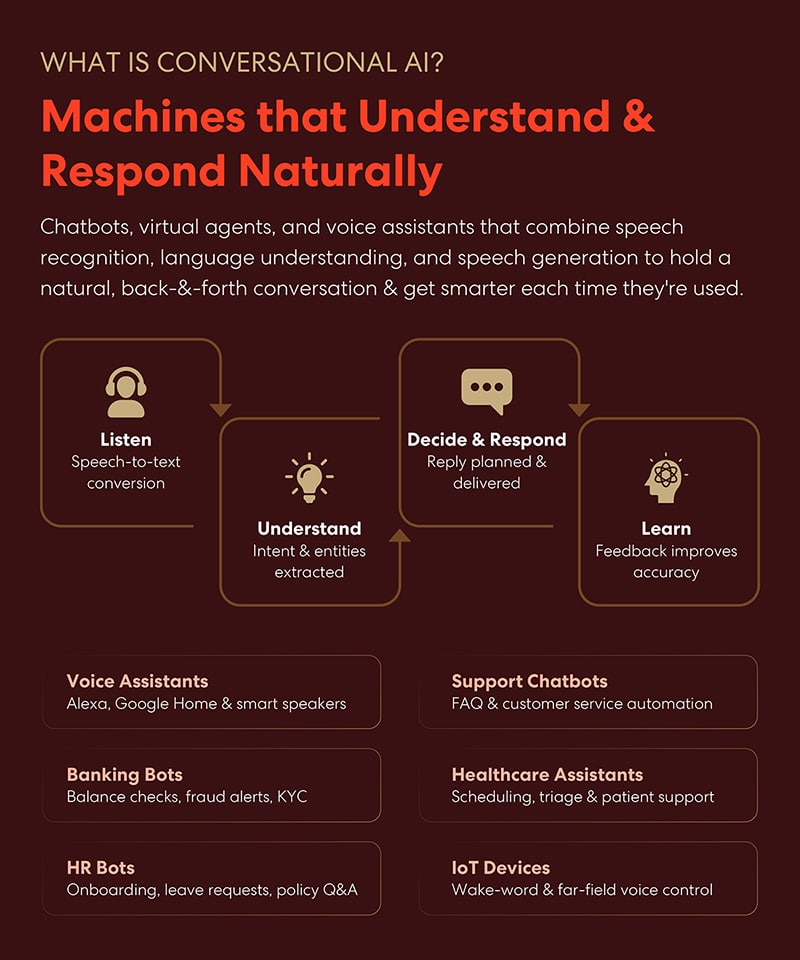
Under varianten kører de alle den samme fire-trins løkke.
- Systemet lytter, konverterer tale til tekst.
- It forstår, udtrækning af intention og enheder — hvad brugeren ønsker, og de specifikke detaljer knyttet til dette ønske.
- It beslutter og svarer, planlægge et svar og levere det.
- Og det lærer, ved hjælp af feedbacksignaler til at forbedre nøjagtigheden på næste tur og hos den næste bruger.
Lyt → forstå → beslut → lær. Hvert produkt nedenfor er et forskelligt domæne, der er viklet rundt om den samme løkke.
- Stemmeassistenter som Alexa og Google Home håndterer åbne husstandsforespørgsler via smarte højttalere.
- Support chatbots automatisere håndtering af ofte stillede spørgsmål og sortering af kundeservice.
- Bankbots køre saldotjek, svindelalarmer og KYC-verifikation.
- Sundhedsassistenter administrere planlægning, symptomtriage og patientstøtte.
- HR-bots spørgsmål om onboarding i felten, anmodninger om orlov og spørgsmål og svar om politikker.
- og IoT-enheder stole på wake-word detection og fjernfeltsstemmestyring, hvor mikrofonen er placeret på den anden side af rummet, og brugeren ikke kigger på en skærm.
Samme pipeline, radikalt forskellige fejlforhold. En detailchatbot, der fejllæser intentionen, koster en konvertering. En sundhedsfaglig triageassistent, der fejllæser intentionen, er en patientsikkerhedshændelse. Den forskel afgøres i dataene, ikke arkitekturen.
Hvordan rå tale bliver til træningsdata
At komme fra en optagelse til et modelklart datasæt kræver to forskellige trin: at vælge, hvordan talen indsamles, og derefter mærke den, så en model kan lære af den. Teams, der behandler disse som ét trin, har en tendens til at ende med et stort datasæt, der lærer de forkerte ting.
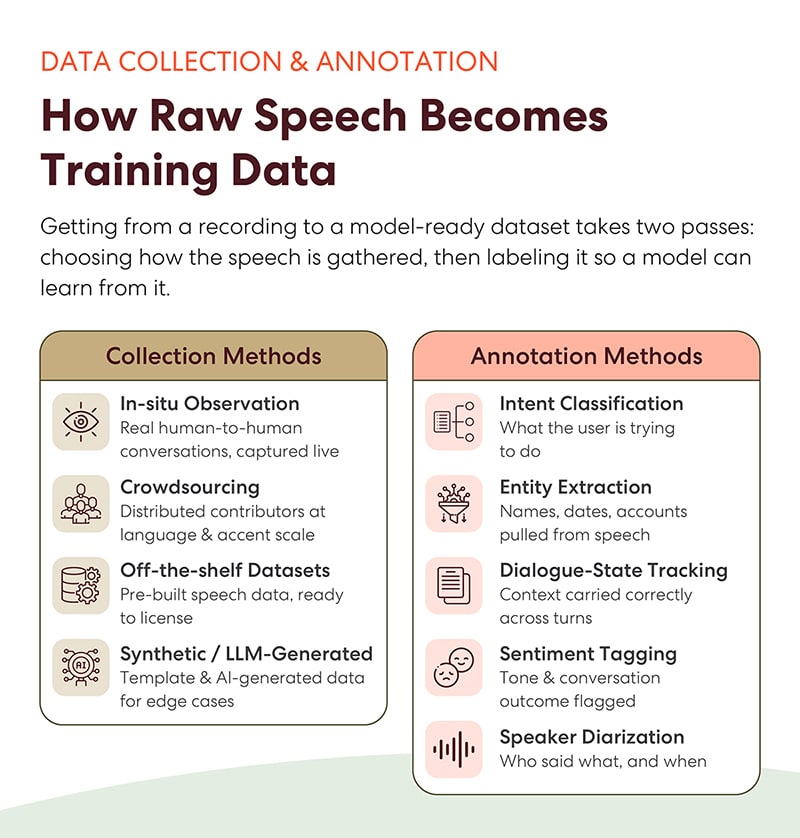
På indsamlingssiden dækker fire metoder de fleste behov.
- In-situ observation optager ægte menneske-til-menneske-samtaler live — det mest trofaste signal, der er tilgængeligt, og det sværeste at opnå i stor skala.
- crowdsourcing distribuerer optagelsen til bidragydere udvalgt efter sprog og accent, hvilket er sådan dækningen opbygges bevidst snarere end ved et uheld.
- Off-the-shelf datasæt levere præbyggede, forhåndsgodkendte taledata klar til licensering, hvilket reducerer tidslinjen i måneder, når domænet er et rimeligt match.
- og syntetisk eller LLM-genereret data udfylder specifikke huller — skabelonbaserede og AI-genererede ytringer til kantsager, der er for sjældne til at vente på.
På annotationssiden forvandler fem mærkningslag lyd til supervision.
- Hensigtsklassificering tagger hvad brugeren prøver at gøre.
- Enhedsudvinding trækker navnene, datoerne og kontonumrene ud af talen.
- Sporing af dialogtilstand bærer kontekst på tværs af runder, så systemet ved, at "den anden" refererer til noget, der blev nævnt for fire runder siden.
- Sentimentmærkning flagtone og samtaleresultat.
- og højttaler diaarisering fastslår, hvem der sagde hvad, og hvornår — ikke-forhandlingsbart for enhver optagelse med flere parter, hvilket vil sige for de fleste reelle opkaldsdata.
Indsaml → transkriber → mærk intentioner og enheder → spor tilstand → dagbogsér → valider. Spring et lag over, og du får en model, der transkriberer flydende og ikke forstår noget.
Hvad "gode data" egentlig måles efter
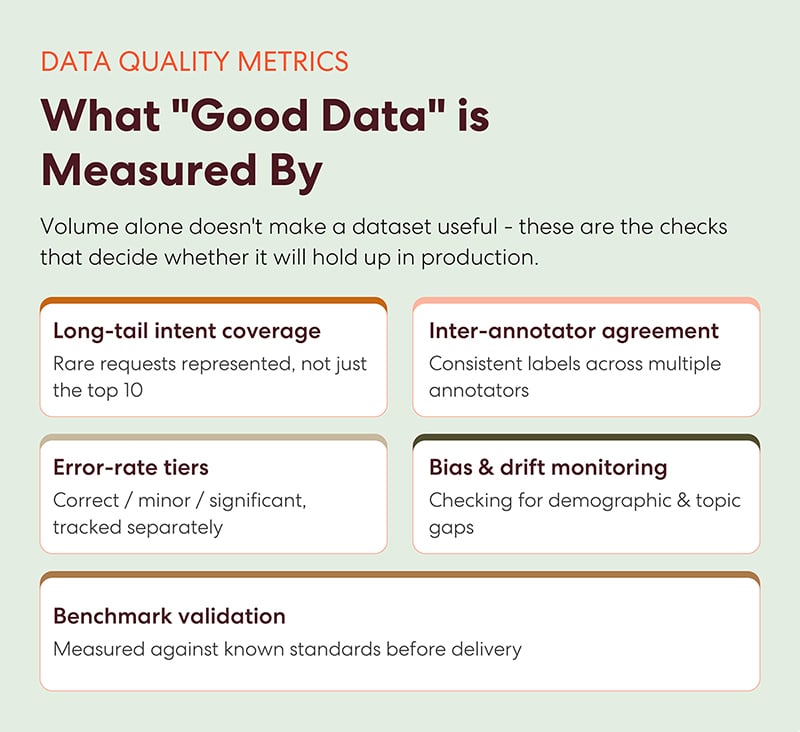
Volumen alene gør ikke et datasæt brugbart. Fem kontroller afgør, om det vil holde i produktion, og de er værd at spørge enhver leverandør direkte om.
- Long-tail intent dækning spørger, om sjældne anmodninger er repræsenteret, ikke kun de ti bedste. De fleste datasæt domineres af den håndfuld intents, som brugerne rammer konstant – og de fleste produktionsfejl sker i halen.
- Aftale mellem annotatorer måler, om flere annotatorer mærker den samme ytring på samme måde; lav overensstemmelse betyder, at dine mærker koder for forvirring snarere end sandhed på jorden.
- Fejlrateniveauer Adskil korrekte fra mindre fra betydelige fejl og spor dem uafhængigt, fordi en fejlrate på 3 % bestående af katastrofale fejlklassifikationer ikke er det samme som en fejlrate på 3 % for trivielle fejl.
- Bias- og driftovervågning tjekker for demografiske og emnemæssige huller og overvåger dem over tid, efterhånden som sprog og brugeradfærd ændrer sig.
- og benchmarkvalidering måler datasættet mod kendte standarder før levering, så kvaliteten er fastslået, før det bliver dit problem.
Disse fem er forskellen på et datasæt, du kan implementere på, og et datasæt, du skal lave om.
Tillid er indbygget i datalaget, ikke boltet på
Taledata indeholder en persons stemme og ord – to af de mest identificerende ting ved dem. Der skal indarbejdes styring fra indsamlingen og fremefter, fordi der ikke er nogen måde at tilføje samtykke med tilbagevirkende kraft til en optagelse, du allerede har trænet på.
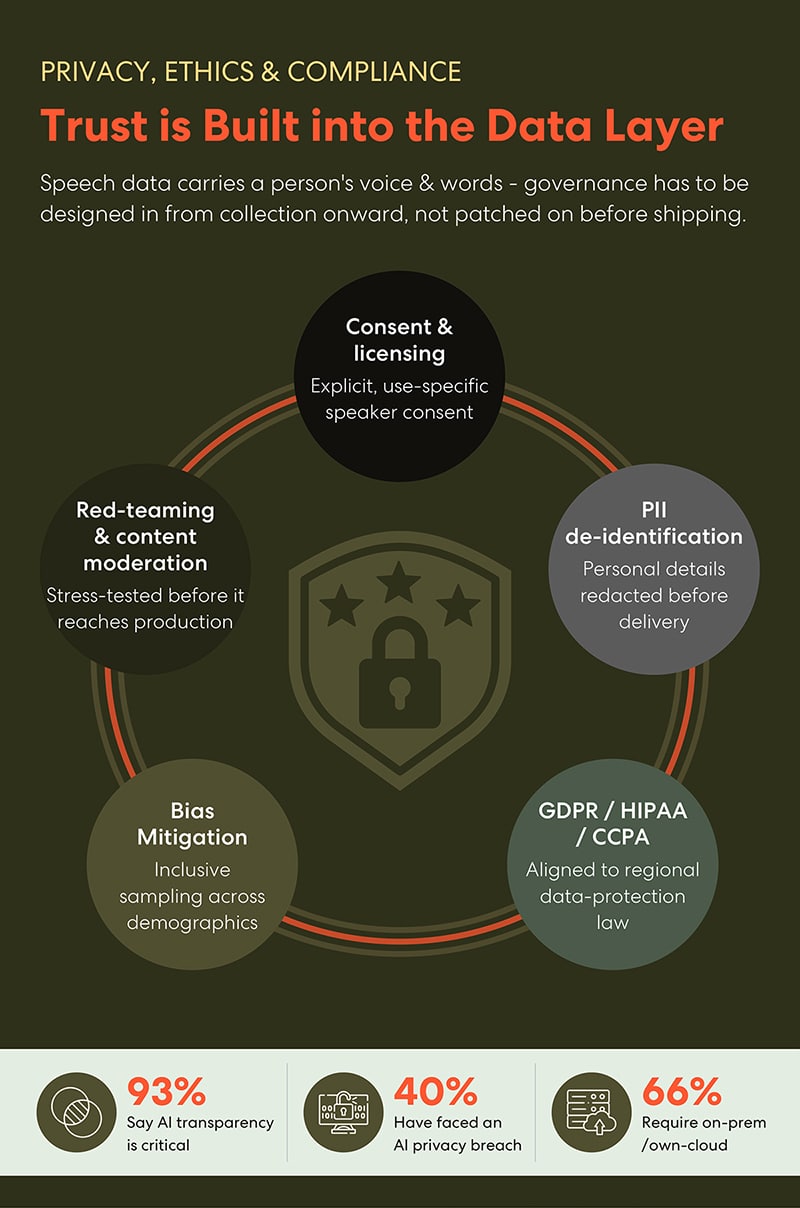
Fem kontroller definerer et forsvarligt datalag.
- Samtykke og licensering betyder eksplicit, brugsspecifikt samtykke fra taleren – ikke en generel klausul i servicevilkår.
- Anonymisering af personoplysninger redigerer personlige oplysninger før levering, ikke efter en hændelse.
- Tilpasning af GDPR, HIPAA og CCPA knytter pipelinen til den regionale databeskyttelseslov, der rent faktisk gælder for implementeringen.
- Bias afbødning indbygger inkluderende stikprøveudtagning på tværs af demografiske grupper i indsamlingsplanen, hvor det ikke koster noget, i stedet for i afhjælpning, hvor det koster alt.
- og red-teaming og indholdsmoderering stresstester systemet, før det når produktionsbrugere.
Markedet har priset dette ind. 93 % af organisationerne siger, at gennemsigtighed i forbindelse med AI er afgørende, 40 % har allerede oplevet et brud på privatlivets fred i forbindelse med AI, og 66 % kræver nu implementering i lokal eller egen cloud. Købere spørger, hvor dataene kommer fra – og i stigende grad ønsker de svaret i en kontrakt.
Hvor samtalebaseret AI dukker op
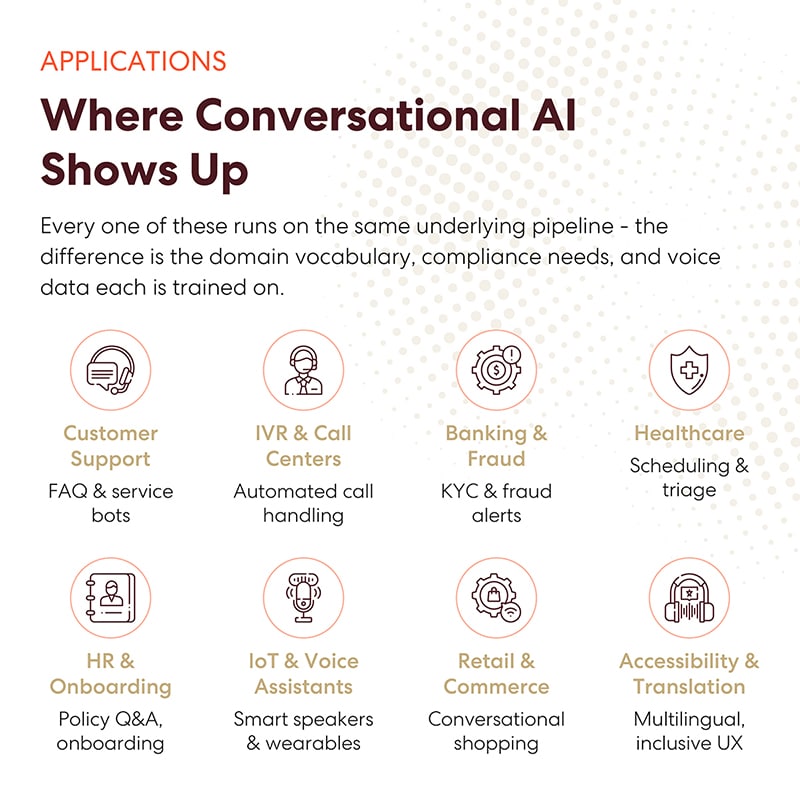
Otte anvendelsesområder tegner sig for størstedelen af virksomhedsimplementeringen.
- Kundesupport kører FAQ og servicebots.
- IVR og callcentre automatiserer opkaldshåndtering og -routing.
- Bankvirksomhed og svindel dækker KYC-verifikation og svindelvarsling.
- Medicinal håndterer planlægning og triage.
- HR og onboarding administrerer spørgsmål og svar til politikker og arbejdsgange for nyansatte.
- IoT og stemmeassistenter smarte højttalere og wearables med strøm.
- Detailhandel og handel muliggør samtalebaseret shopping.
- og tilgængelighed og oversættelse leverer en flersproget, inkluderende brugeroplevelse til de personer, som standardgrænsefladen udelader.
Hver af disse kører på den samme underliggende pipeline. Forskellen er domænevokabularet, compliance-kravene og de stemmedata, som hver enkelt er trænet på. Den sidste variabel er den, som teams investerer for lidt i, og den, der afgør, om implementeringen fungerer uden for demoen.
Bedre samtalebaseret AI starter med bedre data
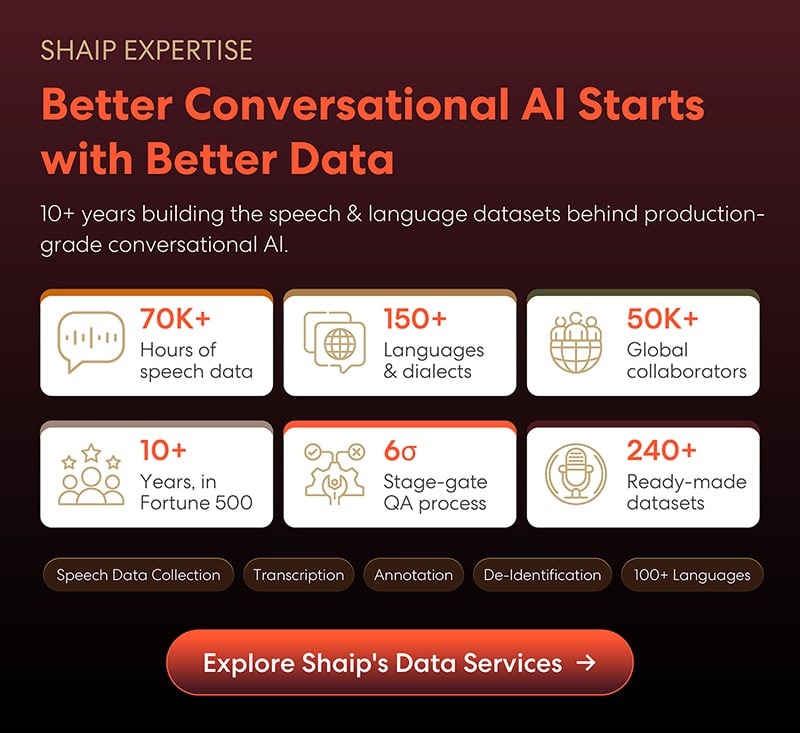
At lukke kløften mellem en fungerende prototype og en assistent i produktionsklassen er et dataoperationsproblem, og det er det, Shaip har brugt over et årti på:
- 70K+ timer af taledata,
- 150+ sprog og dialekter,
- 50+ globale samarbejdspartnere,
- 10 + år betjener Fortune 500 AI-teams,
- a Six-Sigma Stage-Gate QA-proces,
- 240+ færdige datasæt tilgængelig fra hylden, når tidsfristerne ikke tillader afhentning fra bunden.
Målet er det samme på tværs af indsamling af taledata, transkription, annotering og afidentifikation: træningsdata, der afspejler de personer, dit produkt rent faktisk vil tale med, med samtykkespor og kvalitetsmålinger til at bevise det.
The Bottom Line
Konversationsbaseret AI er ikke længere et teknologisk spørgsmål. Løkken er velforstået, modellerne er bredt tilgængelige, og applikationerne er linjeposter i budgetter på tværs af alle brancher. Det, der stadig er virkelig vanskeligt, er datalaget - long-tail dækning, label-aftale, demografisk balance, samtykke og anonymisering.
Det er også der, fordelen ligger. To teams, der bruger den samme model, vil levere produkter af meget forskellig kvalitet, og forskellen vil kunne spores tilbage til, hvad deres systemer blev trænet i. Hvis du bygger konversationsbaseret AI, handler de mest betydningsfulde beslutninger, du træffer, ikke om arkitektur. De handler om, hvis stemmer der er i dit datasæt, hvor godt de er mærket, og om du havde ret til at bruge dem.