
Hver dag producerer din organisation et bjerg af ord. Supportsager, kontrakter, kliniske notater, kundeanmeldelser, e-mails, opkaldsudskrifter. Omkring 80 % af alle virksomhedsdata findes som ustruktureret tekst som denne – og indtil for nylig kunne næsten intet af det analyseres i stor skala. Det lå bare der.
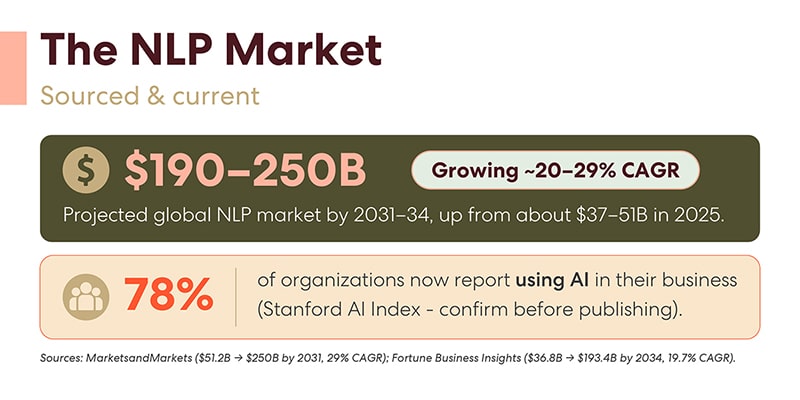
Natural Language Processing ændrede det. Og i 2026, hvor store sprogmodeller nu udfører det hårde arbejde, er NLP gået fra at være et nicheforskningsområde til at være motoren bag næsten alle AI-produkter, du rører ved. Markedet afspejler det: Analytikere forudser, at NLP vil vokse fra omkring 37-51 milliarder dollars i 2025 til 190-250 milliarder dollars i begyndelsen af 2030'erne, og 78 % af organisationerne rapporterer allerede, at de bruger AI i deres forretning.
Så hvad er NLP egentlig i dag, hvordan fungerer det rent faktisk, og hvor er det på vej hen? Lad os gennemgå det.
Lad os først rydde op i den største forvirring: NLP vs. LLM
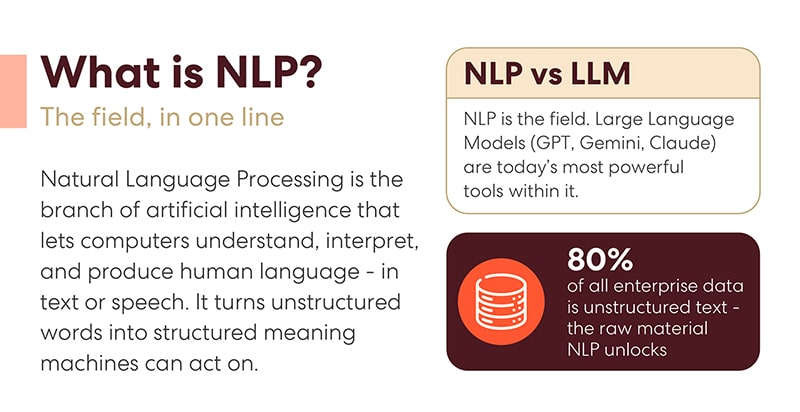
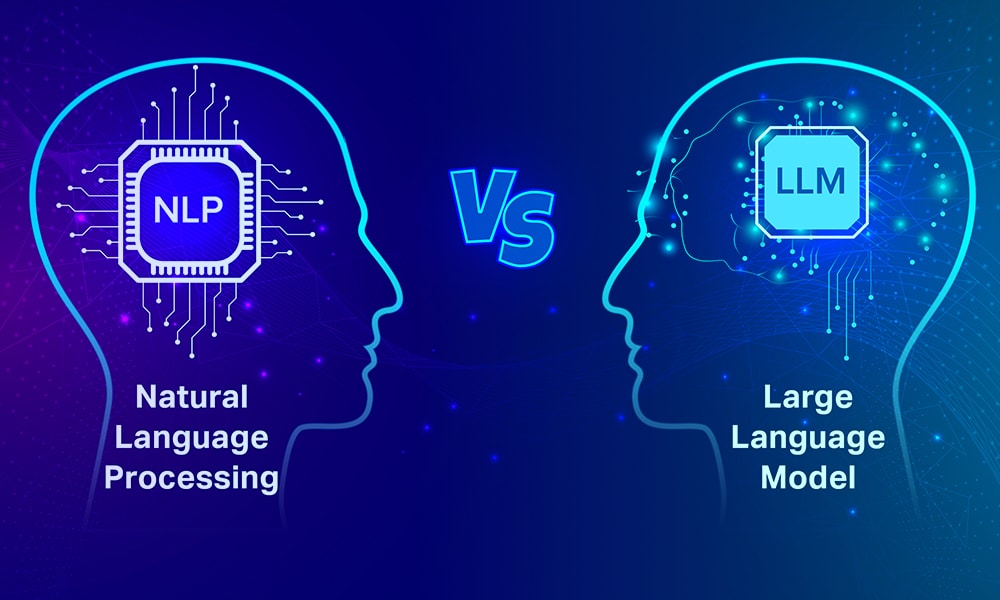
Spørg ti personer, hvad forskellen er på NLP og en LLM, og du får ti ensartede svar. Her er den rene version: NLP er feltet – hele den gren af AI, der beskæftiger sig med maskiner, der forstår, fortolker og genererer menneskeligt sprog. Store sprogmodeller som GPT, Gemini og Claude er værktøjer inden for dette felt. De er tilfældigvis de mest kraftfulde værktøjer, NLP nogensinde har produceret, hvilket er grunden til, at de to begreber bliver sløret sammen.
Tænk på det som medicin og MR-maskiner. MR-scanningen transformerede medicinen, men ingen siger, at medicin er MR. Det samme forhold. Enhver LLM er et NLP-system; NLP er langt større end nogen enkelt model.
Denne sondring har også praktisk betydning. Mange forretningsproblemer – som at sende en supportsag, markere en kontraktklausul eller markere synspunkter i anmeldelser – kræver ikke en frontier LLM. De har brug for den rigtige NLP-tilgang, som ofte er mindre, billigere og hurtigere.
Hvordan moderne NLP rent faktisk fungerer
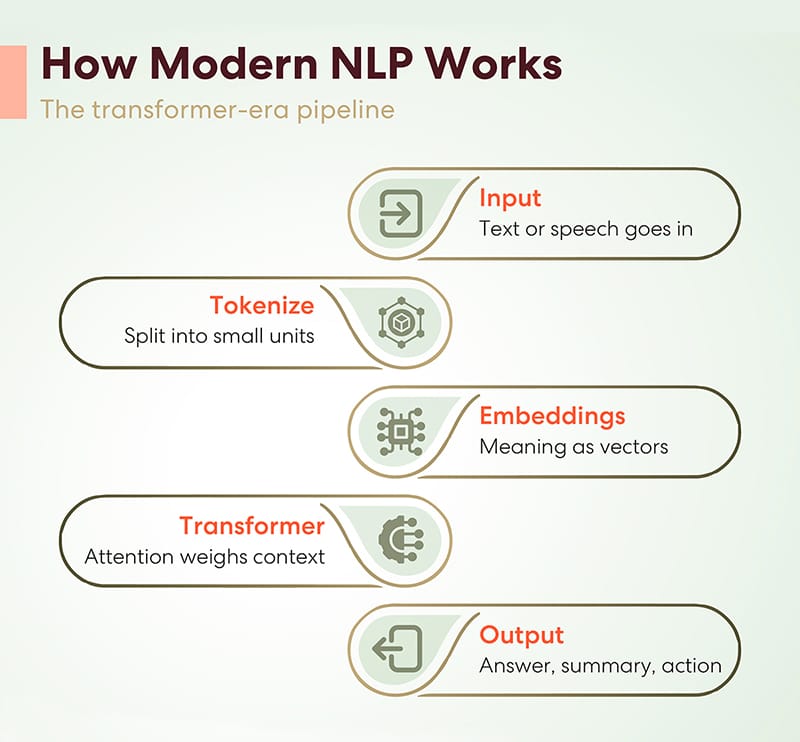
Fjern hypen, og næsten alle moderne NLP-systemer kører på den samme femtrins-pipeline.
Tekst eller tale kommer ind. Systemet tokeniserer det og opdeler sproget i små enheder, som modellen kan håndtere. Disse tokens bliver til indlejringer – numeriske vektorer, der koder betydning, så "læge" og "læge" lander tæt sammen i det matematiske rum. Så kommer den del, der ændrede alt: transformeren , hvis opmærksomhedsmekanisme vejer hvert token mod hvert andet for at finde ud af, hvad der rent faktisk betyder noget i konteksten. Det er sådan, en model ved, at i "banken godkendte lånet" taler man ikke om en flod. Endelig producerer modellen et output – et svar, et resumé, en oversættelse, en handling.
Det var det. Input → tokenize → embed → attend → output. Transformerarkitekturen, der blev introduceret for mindre end et årti siden, ligger nu under stort set alle sproglige AI-systemer i produktion. Når folk taler om "LLM-æraen", taler de i virkeligheden om transformeræraen i stor skala.
Hvad NLP kan gøre – og hvordan jobbeskrivelsen har ændret sig
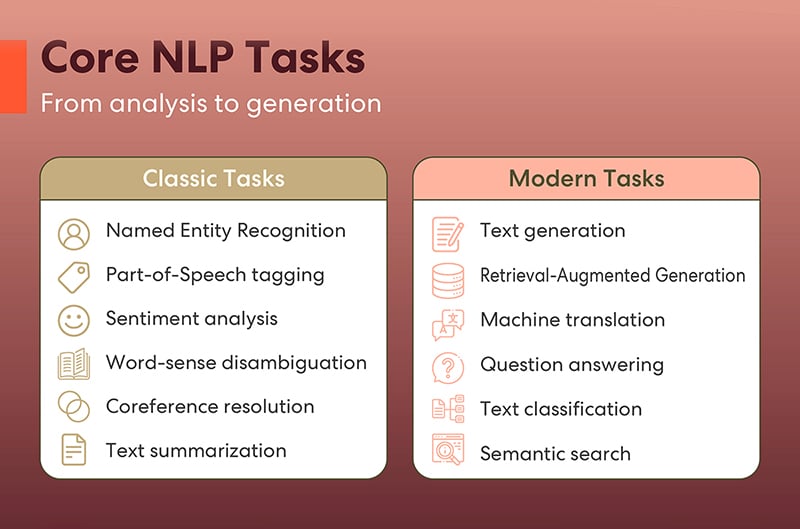
NLP's opgaveliste fortæller historien om feltets udvikling.
De klassiske opgaver handlede om analyse : at trække navne, virksomheder og datoer ud af tekst (navngiven entitetsgenkendelse), tagge ordklasser, detektere sentimenter, fortælle hvilken betydning af et ord der gælder i konteksten (ordforståelse-fjerntydighed), finde ud af hvilket "det" refererer til hvad (koreferenceopløsning) og kondensere lange dokumenter til resuméer. Disse er stadig arbejdsheste - de driver stille og roligt compliance-systemer, søgemaskiner og dokumentpipelines overalt.
Men den moderne æra tilføjede generation til blandingen. Dagens systemer læser ikke bare sprog, de producerer det: de udarbejder tekst, besvarer spørgsmål, oversætter mellem sprog, klassificerer dokumenter i stor skala, driver semantisk søgning, der matcher intention snarere end søgeord, og udfører hentningsudvidet generering – mere om det nedenfor, fordi det fortjener sin egen opmærksomhed.
Skiftet fra analyse til generation er den største enkeltstående ændring i NLP's historie. Maskiner gik fra at bedømme essays til at skrive dem.
De syv idéer, der driver NLP lige nu
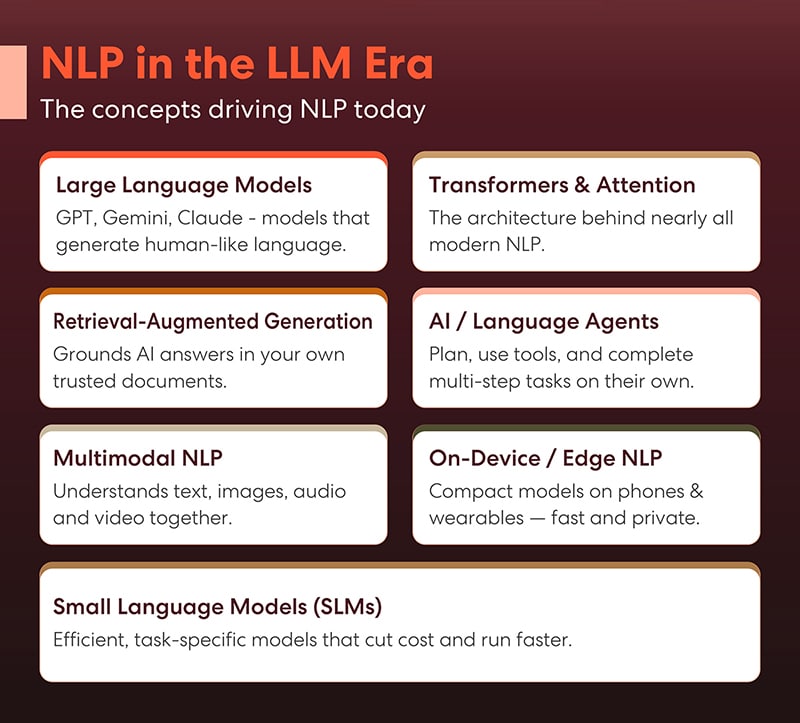
Syv koncepter definerer det nuværende landskab – og kendskab til dem vil hjælpe dig med at analysere enhver AI-leverandørs pitch i 2026.
Store sprogmodeller (LLM'er) er hovednavnet: GPT, Gemini og Claude genererer menneskelignende sprog med en flydende evne, der virkede umulig for et par år siden. De er grunden til, at NLP gik fra at være en backoffice-funktion til en samtale i bestyrelseslokalet.
Transformere og opmærksomhed er maskineriet nedenunder. Næsten alle moderne NLP-systemer – fra førende LLM'er til autofuldførelse på din telefon – er bygget på denne arkitektur, som lader modeller veje kontekst på tværs af et helt dokument på én gang.
Retrieval-Augmented Generation (RAG) er virksomhedens favorit af de syv, fordi den baserer AI-svar i dine egne betroede dokumenter. I stedet for at stole på en models hukommelse, peger du den på din verificerede vidensbase – og hallucinationer falder kraftigt.
AI og sprogagenter bruger modeller fra besvarelse af spørgsmål til færdiggørelse af arbejde: planlægningstrin, kald af værktøjer og udførelse af flertrinsopgaver med minimal overvågning. Hvis 2024 var chatbots' år, tegner 2026 sig til at blive agenternes år.
Multimodal NLP opløser grænsen mellem tekst og alt andet. Moderne systemer behandler tekst, billeder, lyd og video sammen – de læser et diagram, lytter til et opkald og opsummerer begge dele i én omgang.
NLP på enheder/edge-platforme overfører kompakte modeller til telefoner og wearables, hvor inferens sker lokalt. Gevinsten er hastighed og privatliv: dine data forlader aldrig enheden.
Små sprogmodeller (SLM'er) er modtrenden til "jo større er bedre": effektive, opgavespecifikke modeller, der koster en brøkdel af en grænsespecifik LLM og kører hurtigere - ofte det smartere valg til et veldefineret job.
Hvor NLP tjener sin plads
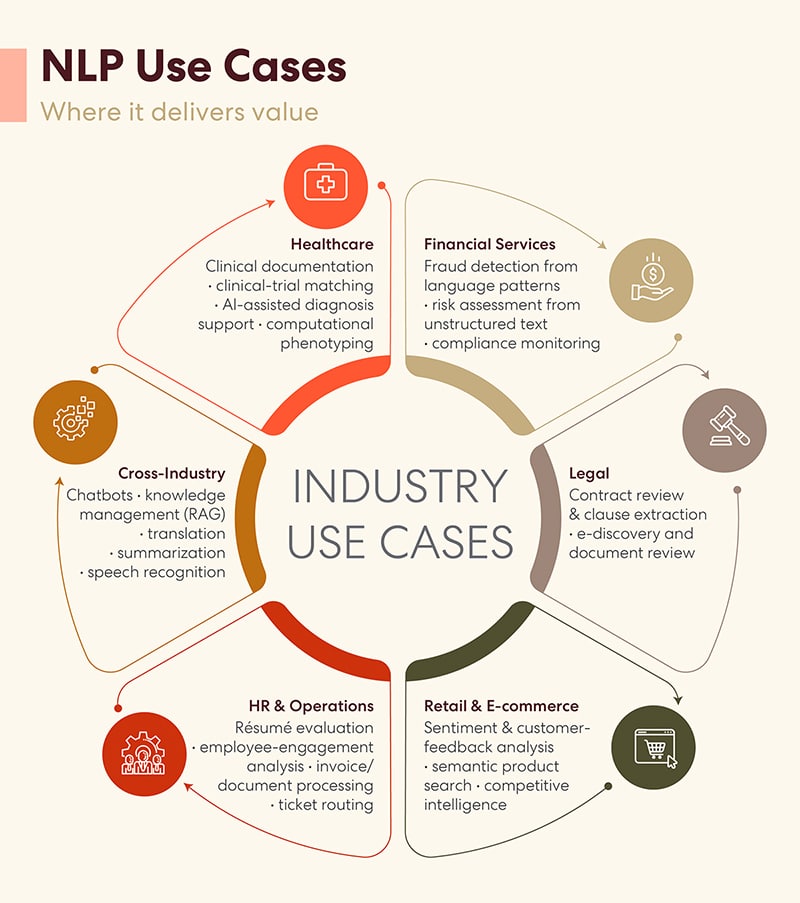
Anvendelsesscenarierne er ikke længere spekulative – de er linjeposter i budgetter på tværs af brancher.
Inden for sundhedsvæsenet udarbejder NLP klinisk dokumentation (som giver læger timer tilbage om ugen), matcher patienter med kliniske forsøg og understøtter diagnoser ved at udvinde noter, som intet menneske kunne læse i stor skala. Inden for finansielle tjenester opdager det svindel gennem sprogmønstre og overvåger kommunikation for compliance - et job, der engang krævede hære af korrekturlæsere. Juridiske teams bruger det til kontraktgennemgang, klausuludtræk og e-discovery, hvilket komprimerer ugers dokumentgennemgang til dage. Detailhandlere udvinder kundefeedback for at opnå sentiment og kraftfuld semantisk søgning, der forstår intention, ikke kun nøgleord. HR- og driftsteams anvender det til CV-screening, engagementanalyse, fakturabehandling og ticketrouting.
Og på tværs af alle brancher: chatbots, vidensstyring via RAG, oversættelse, opsummering og talegenkendelse. Den røde tråd er altid den samme – tekst, der tidligere var ubrugelig, bliver til data, du kan handle ud fra.
Det ærlige billede: Fordele og hvad der stadig går galt
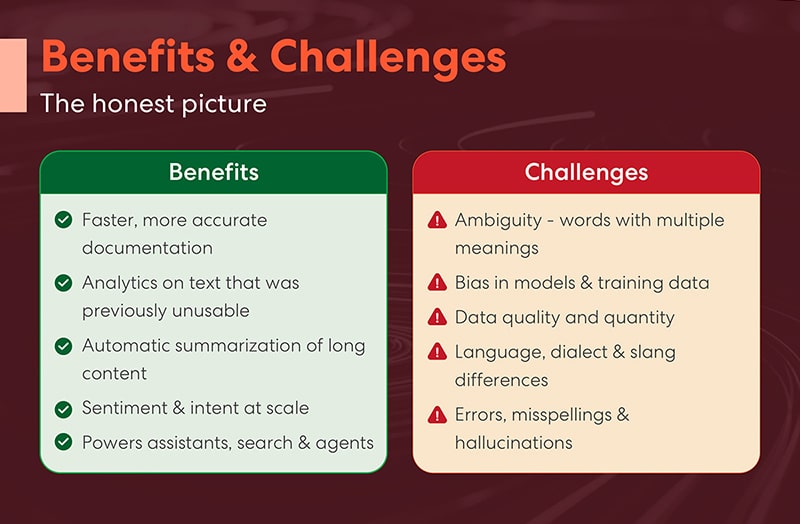
Gevinsten af alt dette er konkret. Dokumentation skrives hurtigere og mere præcist. Tekst, der tidligere var ubrugelig, bliver til analyserbare data. Langt indhold opsummerer sig selv. Følelser og intentioner kan aflæses i stor skala på tværs af millioner af interaktioner. Og hele stakken driver de assistenter, søgemaskiner og agenter, dine teams allerede er afhængige af.
Men det ville være uærligt at afslutte turnéen der, for NLP har i 2026 stadig reelle problemer.
Sprog er tvetydigt – ord har flere betydninger, og modeller snubler stadig over kontekster, som ethvert menneske ville opfatte. Modeller arver bias fra deres træningsdata, hvilket stille og roligt kan skævvride ansættelsesværktøjer, kreditbeslutninger og indholdsmoderering. Datakvalitet er fortsat den uglamourøse flaskehals: modeller er kun så gode som det, de lærer af, og træningsdata af høj kvalitet med gode og velannoterede resultater er knappe og dyre. Dialekter, slang og sprog med lavt ressourceforbrug yder dårligere end standardengelsk. Og hallucinationer – selvsikker, flydende og forkert output – er fortsat den fejltilstand, der holder virksomheders implementeringer forsigtige.
Ingen af disse er grunde til at undlade at implementere. Det er grunde til at implementere dem med omtanke: basér modellerne i verificerede data, evaluer dem på dit sprog og dine brugere, og hold mennesker opdateret, hvor fejl er dyre. Det er værd at bemærke, at de fleste af disse udfordringer kan spores tilbage til den samme grundlæggende årsag - datamodellerne trænes og evalueres ud fra - hvilket er grunden til, at datakvalitet er blevet en konkurrencemæssig differentiator, ikke en afkrydsningsfelt.
Hvad er det næste: Fem tendenser at holde øje med frem til 2026
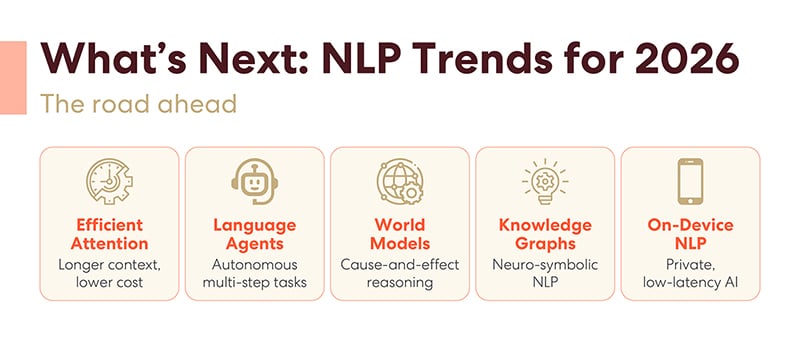
Fremadrettet er der fem udviklinger, der vil definere den næste fase inden for feltet. Effektive opmærksomhedsmekanismer udvider kontekstvinduer, samtidig med at de reducerer omkostningerne, så modeller kan ræsonnere over hele kodebaser eller sagsmapper på én gang. Sprogagenter går fra demoer til produktion og håndterer autonomt flertrinsarbejdsgange. Verdensmodeller sigter mod at give AI ægte årsag-virkning-ræsonnement snarere end mønstermatchning. Videngrafer smelter sammen med neurale tilgange - neurosymbolsk NLP - for at gøre modeloutput mere faktuelle og auditable. Og NLP på enheder bliver ved med at krympe kompatible modeller, indtil privat AI med lav latenstid passer i din lomme.
Mønsteret på tværs af alle fem: mindre råstyrke, mere præcision. Billigere, hurtigere, mere jordnært, tættere på brugeren.
The Bottom Line
NLP i 2026 er ikke længere en fremvoksende teknologi – det er infrastruktur, lige så ubemærkelsesværdig og uundværlig som databaser. De organisationer, der trækker foran, er ikke dem, der spørger, om de skal bruge NLP; det er dem, der spørger, hvilke opgaver de skal automatisere først, hvordan de skal forankre modeller i deres egne data, og hvordan de sikrer, at træningsdataene under det hele er værd at lære af.