Datadrevet beslutningstagning er mantraet for virksomhedens succes og ekspertise i dag. Fra fintech og fremstilling til detail- og forsyningskæder rider enhver industri på big data-bølgen og opnår statistik-baseret beslutningstagning med sine avancerede analysemodeller og algoritmer. I sundhedsområdet bliver dette så meget desto mere givende og livreddende, og det tjener som grundlaget for innovation og videnskabelige fremskridt.
Med et sådant enormt omfang følger også udfordringer. I takt med at efterspørgslen efter sundhedsdata til forskellige formål stiger, er risikoen for databrud og misbrug af følsomme oplysninger også steget. En rapport fra 2023 afslører , at over 133 millioner patientjournaler og -data blev stjålet, hvilket sætter en ny rekord for databrud i sundhedsvæsenet.
Vedtagelsen af HIPAA-forordningen var et betryggende skridt i retning af at optimere databeskyttelsen inden for sundhedsvæsenet , hvilket alene og betydeligt reducerede databrud med 48 % . Rapporter viser også, at 61 % af alle databrud peger på uagtsomhed fra medarbejdere og fagfolk på dette område.
For yderligere at begrænse sådanne angreb og masseeksponering af sårbarheder kommer syntetiske patientdata . Som man siger: "Moderne problemer kræver moderne løsninger", gør fremkomsten af syntetiske data inden for sundhedspleje det muligt for sundhedspersonale at styrke patientdata og bruge AI-modeller til at hjælpe dem med at generere nye data.
I denne artikel vil vi dykke ned i forståelsen af, hvad syntetisk datagenerering handler om, og dens utallige aspekter.
Syntetiske patientdata: Hvad er det?
Syntese er processen med at skabe noget nyt ved at kombinere eksisterende elementer. I samme sammenhæng refererer syntetiske patientdata til kunstigt genererede data fra allerede eksisterende reelle patientdata.
I denne proces studerer statistiske modeller og algoritmer massemængder af patientdata, observerer mønstre og karakteristika og genererer datasæt, der emulerer rigtige data. Nogle af de almindelige teknikker, der anvendes til at generere kunstige patientdata, omfatter:
- Generative Adversarial Networks (GNN'er)
- Statistiske modeller
- Dataanonymiseringsmetoder og mere
Syntetiske data er en fremragende og lufttæt teknik til at tilsidesætte privatlivsproblemer i forbindelse med chancerne for at afsløre patientoplysninger, der er genidentificerbare. For at forstå fordelene ved sådanne data, lad os se på nogle af de mest fremtrædende use cases.
Syntetiske databrug
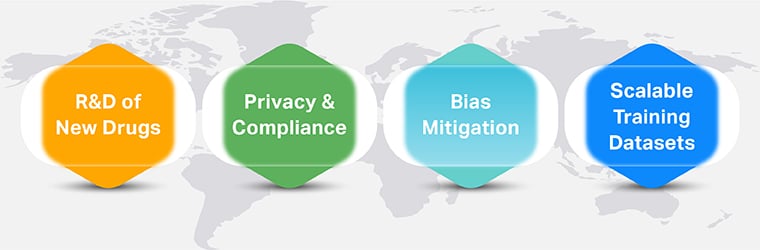
R&D af nye lægemidler og medicin
Generering af kliniske forsøgsdata er diskret, og organisationer skjuler ofte kritiske oplysninger. Til forsknings- og udviklingsformål er datainteroperabilitet dog nøglen til at muliggøre gennembrud. Generering af syntetiske data kan hjælpe forskere med at bruge disse til at skjule vigtige dele af sporbar information og de-silo-data til i fællesskab at studere lægemiddelreaktioner og -modstandere, formuleringer, korrelationsresultater og mere.
Privatliv og overholdelse af lovgivning
Mens der er samtaler om behovet for centraliserede cloud-baserede EPJ-systemer, er der også regulatoriske udfordringer omkring privatliv og sikkerhedsproblemer. Mens datainteroperabilitet er uundgåeligt, skal interessenter på tværs af sundhedsspektret være yderst årvågne med at dele patientdata. Syntetiske data kan hjælpe med at skjule følsomme aspekter, mens de stadig bevarer vigtige berøringspunkter og fungerer som ideelle repræsentative datasæt.
Bias Mitigation In Healthcare
I sundhedsvæsenet er indførelsen af bias medfødt og uundgåelig. For eksempel, hvis der er et udbrud af epidemi på et geografisk sted, der påvirker mænd i alderen mellem 35 og 50 år, indføres bias som standard for denne specifikke persona. Mens kvinder og børn stadig er sårbare over for dette udbrud, har forskere brug for et objektivt grundlag for at underbygge deres resultater. Syntetiske data kan hjælpe med at eliminere bias og levere afbalancerede repræsentationer.
Skalerbare sundhedstræningsdatasæt
På grund af regler som GDPR, HIPAA og mere er tilgængeligheden af datasæt til at træne avancerede sundhedsindbyggede maskinlæringsmodeller stadig sparsommelig. Artificial Intelligence (AI)-systemer og maskinlæringsmodeller kræver enorme mængder træningsdata for konsekvent at blive bedre til at levere præcise resultater.
Generering af syntetisk data er en velsignelse på dette område, da det giver organisationer mulighed for at generere kunstige data, der er skræddersyet til deres volumenkrav, specifikationer og resultater, og samtidig fremme etisk brug af syntetiske data.
Mangler og faldgruber ved syntetiske sundhedsdata
Det faktum, at der er systemer og moduler på plads til kunstigt at generere patient- og sundhedsdata fra eksisterende datasæt, er betryggende. Denne teknik er dog ikke uden sin rimelige andel af mangler. Lad os forstå, hvad de er.