Alle computer vision-teams støder til sidst på den samme væg: de data, du har mest brug for, er de data, du ikke kan få fat i. Nærved-ulykken ved krydset. Fejlen, der dukker op en gang ud af ti tusind enheder. Scenariet, der er for farligt, for sjældent eller for privat til at fange på kamera.
Det er her, syntetiske data fortjener sin plads – computergenererede billeder og scener, der udfylder de huller, som den virkelige verden ikke kan nå. Men syntetiske data er et værktøj, ikke en genvej, og teams, der behandler dem som en gratis frokost, har en tendens til at opdage deres fejltilstande i produktionen. Her er et klart overblik over, hvornår de hjælper, hvornår de giver bagslag, og hvordan man bruger dem godt.
Brug syntetiske data, når du har brug for det
Fem situationer retfærdiggør konsekvent brugen af syntetiske data.

Sjældne edge cases. Nærved-uheld, usædvanlige objektinteraktioner, usædvanlige scenarier – de hændelser, der betyder mest for sikkerhed og robusthed, er netop dem, dit rigtige datasæt knap nok indeholder. Syntetisk generering giver dig mulighed for at fremstille tusind variationer af en hændelse, du kun har set to gange.
Kontrolleret dækning. Samling i den virkelige verden giver dig den belysning, de baggrunde, okklusionsniveauer og kameravinkler, du tilfældigvis optog. Syntetiske pipelines giver dig mulighed for systematisk at gennemgå disse variabler – hver solvinkel, hver delvis okklusion, hver linsehøjde – så dækningen bliver en designbeslutning i stedet for et uheld.
Hurtig iteration. Når du bootstrapper en model før fuldskalaindsamling, får syntetiske data en første versionstræning på dage i stedet for måneder. Du lærer, hvad modellen kæmper med, før du bruger indsamlingsbudgettet.
Begrænsninger for privatliv og overholdelse af regler. I følsomme miljøer, hvor reel optagelse er begrænset – hospitaler, skoler, arbejdspladser med strenge privatlivsregler – leverer syntetiske scener træningssignaler uden et eneste rigtigt ansigt eller identitet i pipelinen.
Støtte til klassebalance. Når nogle klasser er stærkt underrepræsenterede, træner modeller ustabilt og ignorerer mindretallet. Syntetiske eksempler kan styrke underrepræsenterede klasser for at genoprette træningsstabilitet.
Pas på: Syntetiske stoffer kan give bagslag, hvis
Nu til den ærlige del. Syntetiske data fejler på forudsigelige måder, og alle disse fejl kan undgås, hvis man ved, hvordan man leder efter dem.
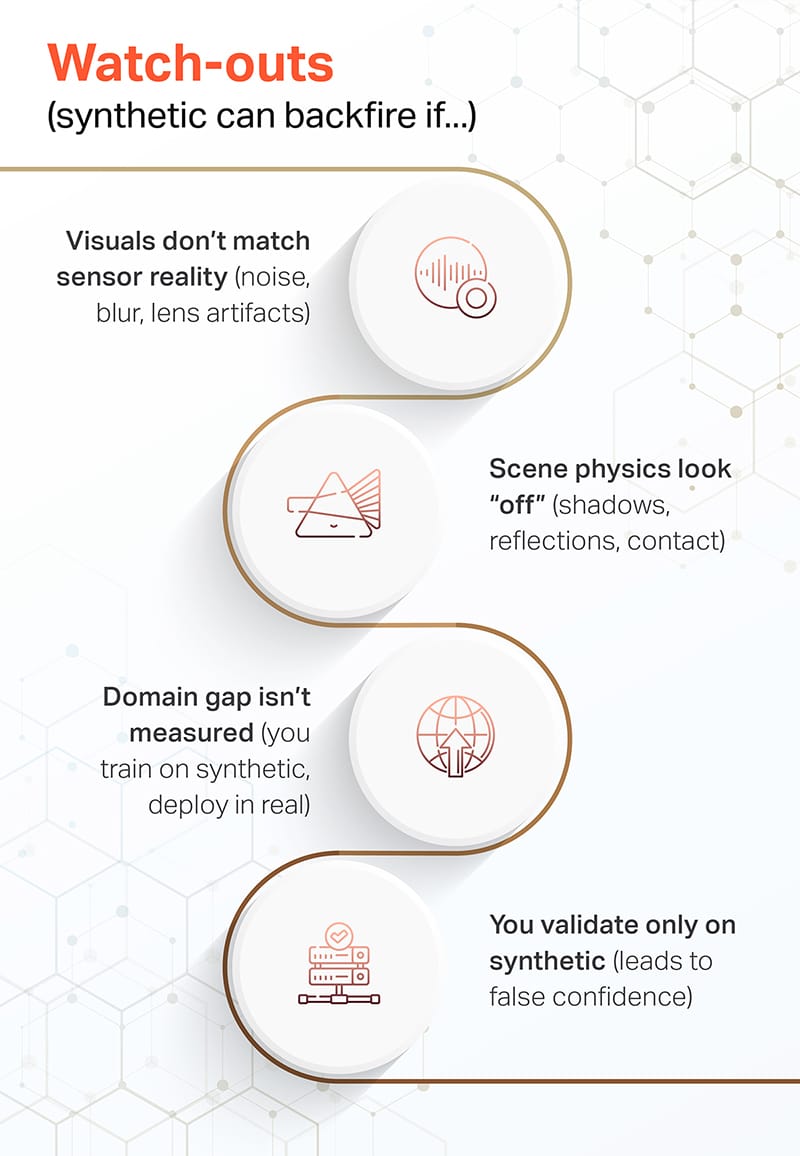
Billederne stemmer ikke overens med sensorernes virkelighed. Dit implementeringskamera har støj, sløring og linseartefakter. Hvis dine syntetiske billeder er renere end noget, din sensor nogensinde vil producere, lærer modellen en verden at kende, der ikke eksisterer.
Scenens fysik ser "skæv" ud. Skygger, der falder den forkerte vej, refleksioner, der ikke opfører sig korrekt, objekter, der ikke helt har kontakt med overflader. Mennesker ignorerer disse faktorer; modeller optager dem som sandheden i virkeligheden.
Domæneforskellen måles ikke. Den klassiske fiasko: træn på syntetiske værktøjer, implementer i virkeligheden, og kvantificer aldrig forskellen mellem de to. Hvis du ikke måler domæneforskellen, gætter du.
Du validerer kun på syntetiske testsæt. Dette er den farligste, fordi den skaber falsk tillid – en model, der scorer fremragende på syntetiske testsæt og falder fra hinanden på reelle input. Syntetisk validering fortæller dig, at modellen har lært din simulator at kende, ikke din verden.
Bedste praksis-tilgangen
Teams, der har succes med syntetiske data, følger den samme femtrinsløjfe.
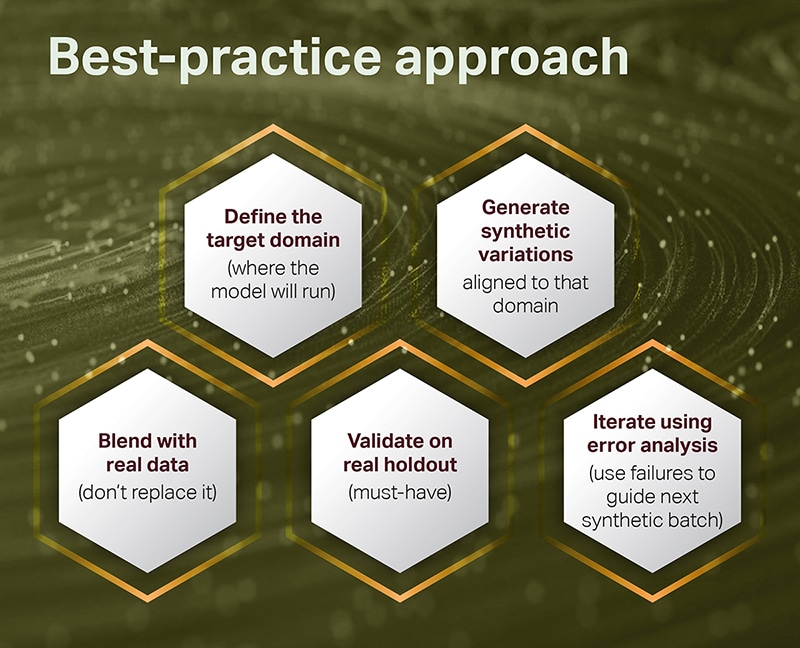
For det første skal du definere måldomænet – de faktiske forhold, hvor modellen vil køre, helt ned til sensoren, miljøet og belysningen. For det andet skal du generere syntetiske variationer, der er justeret til dette domæne , ikke generiske, pæne gengivelser. For det tredje skal du blande dem med rigtige data – syntetiske data supplerer rigtige data; de erstatter dem ikke. For det fjerde skal du validere på et rigtigt holdout-sæt . Dette er et must-have, punktum: dit benchmark skal være rigtige data, som modellen aldrig har set før. Og for det femte skal du iterere ved hjælp af fejlanalyse – lad modellens virkelige fejl guide, hvad den næste syntetiske batch skal indeholde.
Definer → generer → blend → valider på reel → iterer. Løkken er vigtigere end noget enkelt trin.
Skal du bruge syntetiske data? En hurtig beslutningsramme
Fire spørgsmål afgør de fleste debatter.
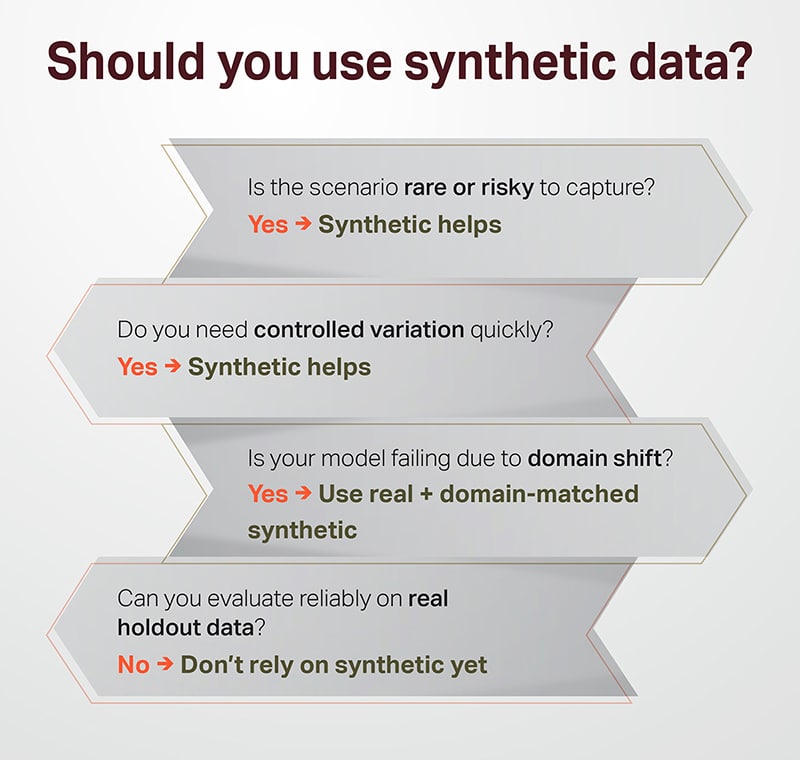
Er scenariet sjældent eller risikabelt at indfange ? Hvis ja, hjælper syntetisk metode. Har du brug for kontrolleret variation hurtigt ? Hvis ja, hjælper syntetisk metode. Fejler din model på grund af domæneskift ? Hvis ja, brug reelle data plus domæne-matchet syntetisk metode - syntetisk metode alene vil ikke lukke et hul, den ikke kan se. Og endelig: kan du evaluere pålideligt på reelle holdout-data ? Hvis nej, så stol ikke på syntetisk metode endnu - byg dit reelle evalueringssæt først, for uden den kan du ikke afgøre, om syntetisk metode hjælper eller stille og roligt skader.
The Bottom Line
Syntetiske data er et af de mest kraftfulde værktøjer i computer vision-værktøjssættet – til edge cases, dækning, hastighed, privatliv og balance. Det er også et af de nemmeste at misbruge, fordi dets fejltilstande gemmer sig bag flotte målinger indtil implementeringsdagen.
De teams, der gør det rigtigt, behandler det som en ingeniørdisciplin: reelle data som fundament, syntetiske data som målrettet forstærkning og validering fra den virkelige verden som den ikke-forhandlingsbare dommer. Det er den tilgang, Shaip bruger til CV-teams – planlægning af den rette blanding af reelle og syntetiske data med målbar kvalitetssikring og implementeringsfokuseret validering, så den model, der fungerer i træning, er den samme, der fungerer i felten.