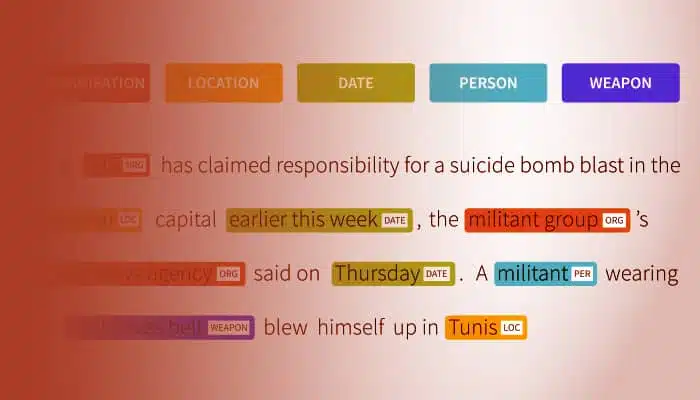
Tekstannotationstjenester til NLP, generativ AI og LLM-træning
Outsource tekstannotering på over 150 sprog — entitetsgenkendelse, sentiment, klassificering og LLM-træningsdata leveret af ekspertannotatorer
Hvorfor er tekstannotation nødvendig – og hvorfor dine NLP- og LLM-modeller har brug for det
Tekstannotering er processen med at mærke ustruktureret tekst – e-mails, chatlogs, supportsager, kliniske notater, juridiske kontrakter, sociale opslag – så naturlig sprogbehandling (NLP) og store sprogmodeller (LLM'er) kan lære mønstrene. Uden annoterede træningsdata af høj kvalitet præsterer selv den stærkeste modelarkitektur under niveau.
Hos Shaip bygger vi annoterede tekstdatasæt til fire kerneopgaver: træning af en model fra bunden, finjustering af en open source LLM, evaluering af modeloutput og kørsel af kontinuerlig forstærkningslæring med menneskelig feedback (RLHF). Hvert datasæt er mærket af en domæneekspert-annotator, dobbelt-reviewet af en Six Sigma-uddannet QA-anmelder og leveret i det skema, din træningspipeline forventer.
Hvis dit datavidenskabelige team i øjeblikket bruger 80 % af sin tid på at rense og mærke tekst i stedet for at bygge modeller, er det hullet, som outsourcing af tekstannoteringer har til formål at lukke.
Nøjagtig tekstnotering til maskinlæring
Så meget som konceptet føles spændende, kan forberedelse af lignende ressourcer kræve en stor indsats, erhvervserfaring og ekspertniveau. Det er her, Shaip dukker op som et pålideligt tekstannotationsfirma med stor fokus på at mærke de indsamlede data til perfektion.
Med Shaip ombord kan du stoppe med at bekymre dig om de opfattende evner i dine maskinlæringsopsætninger, da de AI -træningsdata, der tilbydes, er forberedt på at fortolke svar, semantik og ja, endda følelser.
Leder du efter mere, her er nogle af de ekstra fordele ved at stole på Shaip som din outsourcingpartner til tekstannotering:
- Målintensiv tilgang
- Fokus på kontekst og klarhed i kommunikation
- Evne til at træne maskiner med sproglige elementer
- Udtømmende søgemaskine mærkning
- Skalerbare tilbud
- Flersproget maskinoversættelse
Service katalog
Typer af tekstannotationstjenester, vi leverer
Alle NLP- og generative AI-anvendelsescases kortlægges til en eller flere af ni annotationsteknikker. Shaip leverer alle ni – inden for én platform, én projektleder og ét kvalitetsrammeværk.
Tekstklassificering og emnemærkning
Enkelt-label, fler-label og hierarkisk klassificering til spamdetektion, emnerouting, nyhedskategorisering, intentionssortering og indholdsmoderering. Bygget til at skalere til taksonomier med hundredvis af kategorier.
Sproglig annotation (POS, fonetisk, morfologisk)
Ordklassetagging, fonetisk transkription, morfologisk tagging og afhængighedsparsing — bruges til sprogmodellering med lavt ressourceforbrug, maskinoversættelsestræning og akademiske korpusa.
Genkendelse af navngivne enheder (NER) og enhedstilknytning
Vi tagger personer, organisationer, steder, datoer, monetære værdier, medicinske enheder, juridiske klausuler og produktkoder i ustruktureret tekst – og linker hver enhed til en kanonisk vidensbase (Wikidata, UMLS, ICD-10 eller en klientontologi).
Subjekt-handling-objekt (SAO) og relationsannotation
Triplet-udtrækning til konstruktion af vidensgrafer, hændelsesudtrækningssystemer og patentintelligens. SAO-mærkning omdanner flade sætninger til maskinfornuftig struktur.
Annotation af følelser og følelser
Flerklassefølelser (positive/neutrale/negative) og mere detaljeret følelsesmærkning på tværs af anmeldelser, sociale opslag, supportsager og spørgeskemabesvarelser. Flersproget dækning håndterer kulturelle nuancer – ironi på engelsk er ikke lig med ironi på hindi eller arabisk.
Intent-annotation til chatbots og virtuelle assistenter
Intention på ytringsniveau og entitetsmærkning — det grundlæggende datasæt for enhver samtalebaseret AI, IVR-opgradering eller stemmeassistentfærdighed.
Koreferenceopløsning og linkning på dokumentniveau
Flersætnings- og krydsdokument-koreferencer — opløser "hun", "patienten", "tiltalte" tilbage til den kanoniske enhed. Kritisk for lange opsummeringer og klinisk narrativ AI.
Hurtig respons og RLHF-mærkning for LLM'er
Præferencesammenligning, instruktion-respons-par, tankekæder, modstanderprompts fra det røde hold og harmløshedsscoring - det menneskelige feedback-lag, som moderne LLM-finjustering er afhængig af.
Dokumentannotering og OCR efter redigering
Mærkning på feltniveau på scannede PDF'er, fakturaer, elektroniske patientjournaler, ID-kort og strukturerede formularer — parring af OCR med human-in-the-loop-korrektion til intelligente dokumentbehandlingspipelines (IDP).
Hvorfor teams vælger Shaip som deres outsourcingpartner til tekstannotering
150+ sprog
Dækning af annotatorer på tværs af alle større indoeuropæiske, kinesisk-tibetanske, afroasiatiske og austronesiske sprog samt ressourcefattige indiske og afrikanske sprog. Flersproget holdning, NER og intention leveret under én SOW.
Six Sigma kvalitetsramme
Proces ejet af Six Sigma Black Belts. To-trins annoterings- + QA-workflow. Kontinuerlig IAA-overvågning (inter-annotator agreement) med målgrænser fastsat pr. projekt.
Robust annotationsplatform
Webbaseret, revisionslogget, rollesegmenteret annotationsgrænseflade. Understøtter tekst, lyd og billede i én arbejdsgang – nyttigt, når din roadmap inkluderer multimodal annotation.
Domænetrænede annotatorer
Annotationsspecialister dirigeret efter domæne — klinisk til sundhedsprojekter, JD-akkrediterede korrekturlæsere til jura, finanskandidater til kapitalmarkedsarbejde, modersmålstalende til alle flersprogede projekter.
Robust overholdelse
HIPAA, GDPR, SOC 2 og ISO 27001-overholdelse - Reviderede kontroller for sundhedsinformation, personoplysninger i EU og SOC 2 Type II-sikkerhed. Redigering af personoplysninger er tilgængelig, før nogen menneskelig annotator ser dataene.
Fleksibel kommerciel model
Pr. mærket objekt, pr. annotationstime, pr. projekt eller fuldt administreret retainer.
Hvorfor outsource tekstannotationstjenester til Shaip
Outsourcing af tekstannotering er ikke en omkostningsbeslutning – det er en hastighedsbeslutning. Fire grunde til, at interne teams overdrager tekstmærkning til Shaip:
Befri dine data scientists fra 80% tidsafgift
Branchens benchmarks placerer 80% af et data science-teams indsats på datarensning og -forberedelse. Outsourcing af tekstannotering generobrer denne båndbredde til modeludvikling, fejlanalyse og produktionsimplementering – det arbejde, data scientists rent faktisk bliver betalt for at udføre.
Domæneekspertkvalitet, ikke generalistarbejde
En kliniker annoterer kliniske noter korrekt første gang. En advokatfuldmægtig annoterer kontrakter korrekt første gang. Generalistiske annotationsteams – uanset om de er crowdsourcede eller interne juniormedarbejdere – gentager arbejdet to eller tre gange. Domænerouting lukker QA-løkken sammen.
Elastisk skala efter behov
Annotationsmængden kommer sjældent jævnt. Pilotfaser kræver ti annotatorer; præ-lancering kræver tre hundrede; produktionsvedligeholdelse kræver tyve. Outsourcing omdanner medarbejderrisiko til en variabel omkostning og fjerner ansættelse-oplæring-bevaring-cyklussen.
Eliminer intern bias
Annotatorpuljer, der stammer fra et enkelt team, en region eller en baggrund, indkoder utilsigtet deres syn på verden i modellen. Annotationspuljer med flere regioner og flere baggrunde – kombineret med bias-bevidst QA-sampling – producerer datasæt, der generaliserer på tværs af de populationer, din model rent faktisk vil betjene.
Tjenester tilbydes
Ekspertindsamling af billeddata er ikke praktisk til omfattende AI-opsætninger. Hos Shaip kan du endda overveje følgende tjenester for at gøre modeller langt mere udbredte end normalt:
Lydkommentartjenester
Mærkning af lydkilder, tale og stemmespecifikke datasæt via relevante værktøjer som talegenkendelse, højttalerdiarisering, følelsesgenkendelse og mere er noget, Shaip har specialiseret sig i.
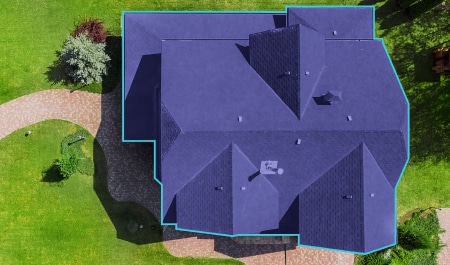
Billedannoteringstjenester
Vi sætter en ære i at mærke, segmenterede billeddatasæt for at træne kræsne computervisionsmodeller. Nogle af de relevante teknikker inkluderer grænsegenkendelse og billedklassificering.
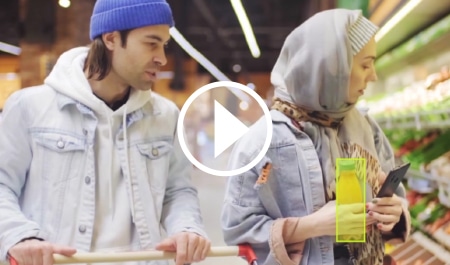
Videoanmærkningstjenester
Shaip tilbyder avancerede videomærkningstjenester til træning af Computer Vision-modeller.
Målet her er at gøre datasæt anvendelige med værktøjer som mønstergenkendelse, objektdetektion og mere.
Anbefalede ressourcer
Købervejledning
Købers vejledning til datanotering og datamærkning
Så du vil starte et nyt AI / ML-initiativ og er klar over, at det at finde gode data vil være et af de mere udfordrende aspekter af din operation. Output fra din AI / ML-model er kun så god som dataene.
Offerings
Case-specifik tekstdataindsamling
Den sande værdi af Shaips kognitive tekstdataindsamlingstjenester er, at det giver organisationer nøglen til at låse op for kritisk information, der findes dybt inde i ustrukturerede tekstdata.
Blog
Sikring af nøjagtig datanotering til AI-projekter
En robust AI-baseret løsning er bygget på data – ikke bare hvilken som helst data, men højkvalitets, nøjagtigt annoterede data. Kun de bedste og mest raffinerede data kan drive dit AI-projekt, og denne datarenhed vil have en enorm indflydelse på projektets resultat.
Fremhævede klienter
Styrke teams til at opbygge verdensledende AI-produkter.
NLP-system i pipelinen? Invester i Avant-grade tekstetiketteringstjenester - vores eksperter tager sig af komplekse etiketter
Ofte stillede spørgsmål (FAQ)
1. Hvad er tekstannotering?
Tekstannotering er processen med at mærke ustruktureret tekst – e-mails, kontrakter, supportsager, kliniske noter, sociale opslag – med strukturerede tags, så NLP og store sprogmodeller kan lære mønstrene i den. Almindelige annoteringstyper omfatter navngivet entitetsgenkendelse (NER), sentimentanalyse, intentionsannotering, tekstklassificering, entitetslinkning og SAO (subjekt-handling-objekt) tagging. Tekstannotering er fundamentet for ethvert NLP-produktionssystem, enhver chatbot, enhver domænespecifik LLM og enhver moderne dokument-AI-pipeline.
2. Skal jeg outsource tekstannotering eller bygge den internt?
Beslutningen afhænger normalt af tre faktorer. (1) Hastighed: Interne teams bruger typisk 8-12 uger på at ansætte og uddanne annotatorer; outsourcing starter produktionen af mærkede data inden for 7-14 dage. (2) Kvalitet: Domænetrænede outsourcede annotatorer leverer højere overensstemmelse mellem annotatorer end generalistiske interne teams, især inden for sundheds-, juridisk og finansiel tekst. (3) Omkostningselasticitet: Annotationsvolumen svinger; outsourcing konverterer en fast omkostning pr. medarbejderstab til en variabel omkostning pr. objekt eller pr. time. De fleste teams outsourcer hovedparten og har en lille intern pulje af QA-anmeldere – hybridmodellen.
3. Hvordan håndterer Shaip flersprogede tekstannotationsprojekter?
Shaip administrerer flersprogede projekter med global ekspertise og avancerede værktøjer, hvilket sikrer præcis mærkning på tværs af forskellige sprog og regioner.
4. Hvordan bruges tekstannotering til at træne AI-chatbots og virtuelle assistenter?
Tekstannotering hjælper chatbots og virtuelle assistenter med at forstå brugerforespørgsler ved at tagge enheder, intentioner og følelser, hvilket gør dem i stand til at give præcise og kontekstbevidste svar.
5. Hvilke almindelige typer tekstannoteringer tilbydes af Shaip?
Shaip tilbyder tjenester som entitetsannotering, sentimentannotering, tekstklassificering, entitetslinkning, subjekt-handling-objekt (SAO)-annotering og sproglig annotering for effektivt at træne NLP-modeller.
6. Hvordan forbedrer tekstannotering sentimentanalyse i AI-modeller?
Tekstannoteringer tagger data med følelser som positive, negative eller neutrale, hvilket gør det muligt for AI at registrere meninger og følelser for bedre analyse af kundefeedback.
7. Hvorfor er entitetsannotering afgørende for udvikling af chatbots?
Enhedsannotering identificerer vigtige oplysninger som navne, datoer og placeringer, hvilket gør det muligt for chatbots at levere relevante og personlige svar.
8. Hvilke værktøjer og teknikker bruger Shaip til tekstannotering?
Shaip bruger avancerede annotationsværktøjer og -teknikker som semantisk analyse, videnslinking og ordklassetagging, hvilket sikrer resultater af høj kvalitet.
9. Hvordan sikrer Shaip datakvalitet og eliminerer bias i tekstannotering?
Shaip anvender strenge kvalitetskontrolprocesser, flerlagede gennemgange og ekspertannotatorer for at levere nøjagtige og upartiske datasæt, der er egnede til AI-træning.
10. Hvad er udfordringerne ved at annotere store datasæt til NLP?
Udfordringerne omfatter at opretholde datakonsistens, håndtere domænespecifikke data og styre flersprogede projekter. Shaip håndterer disse med skalerbarhed, ekspertise og robust kvalitetssikring.
11. Hvad er nogle branchespecifikke anvendelsesscenarier for tekstannotering?
Shaip understøtter applikationer inden for sundhedspleje, e-handel, konversationel AI og teknologi ved at træne AI-modeller til opgaver som medicinsk dataanalyse, personlige anbefalinger og oversættelsessystemer.
12. Kan Shaip levere tekstannotering til generativ AI- og LLM-træning?
Ja. Shaip kører fire LLM-specifikke annotationsworkflows: Oprettelse af Supervised Fine-Tuning (SFT) instruktion-svar-par, sammenligning af RLHF- præferencer og rationalemærkning, RAG-evaluering for hentningstroværdighed og citeringskorrekthed og Red Teaming for adversarielle prompts og harmløshedsscoring. Output leveres i JSONL eller OpenAI-chatformatet til direkte indtagelse i Hugging Face, OpenAI-finjustering eller brugerdefinerede træningspipelines.
