
-
-
Firmanavn
Byg altid-lytende stemmeapps med brugerdefinerede træningsdata for vækkeord. Højere detektionsnøjagtighed, færre falske aktiveringer.
Stemmeassistenter har dramatisk ændret den måde, kunderne interagerer med deres enheder på. De har gjort det nemmere for brugerne at udforske produkter og tjenester – hurtigt og effektivt. Men lytter stemmeapplikationen? For at sætte disse applikationer i høj drift, skal de vækkes og gå fra passiv til aktiv lytning ved hjælp af WAKE WORDS. 'Alexa' og "Hey Siri" er to af de mest populære vågne ord i verden.
I 2024 forventes antallet af digitale stemmeassistenter at nå 8.4 milliarder enheder – mere end verdens befolkning.
Markedet for stemmeassistentapps forventes at stige fra 2.8 milliarder dollars i 2021 til 11.2 milliarder dollars i 2026, med en årlig vækstrate (CAGR) på 32.4 %.
Et "wake word" er et specifikt ord eller en sætning, såsom "Hey Siri", "Okay Google" og "Alexa", designet til at aktivere en stemmeaktiveret enhed til at reagere, når den ytres. Et "always-lytting"-wake word, der er lokalt integreret i enheden, reducerer dog responstiden drastisk og øger identifikations- og behandlingsnøjagtigheden af "wake word", selv uden en internetforbindelse. Shaip indsamler træningsdata om "wake word" på tværs af over 100 sprog, forskellige accenter, aldersgrupper og virkelige støjmiljøer for at maksimere detektionsnøjagtigheden og minimere falske aktiveringer. De er også kendt som:
Med Shaip's tilbyder altid lyttende wake word-træning, er dine stemmeassistentmodeller altid indstillet til at lytte efter wake-ordet, men uden egentlig at optage eller overføre data til skyen. Partnerskab med Shaip giver dig fordelen ved at arbejde med eksperter. Med vores omfattende erfaring med at bruge AI- og ML-teknologi til udvikling af stemmeassistenttræning hjælper vi dig med at eliminere privatlivsrisici, forbedre brugeroplevelsen, reducere udviklingsomkostninger og forbedre skalerbarheden.
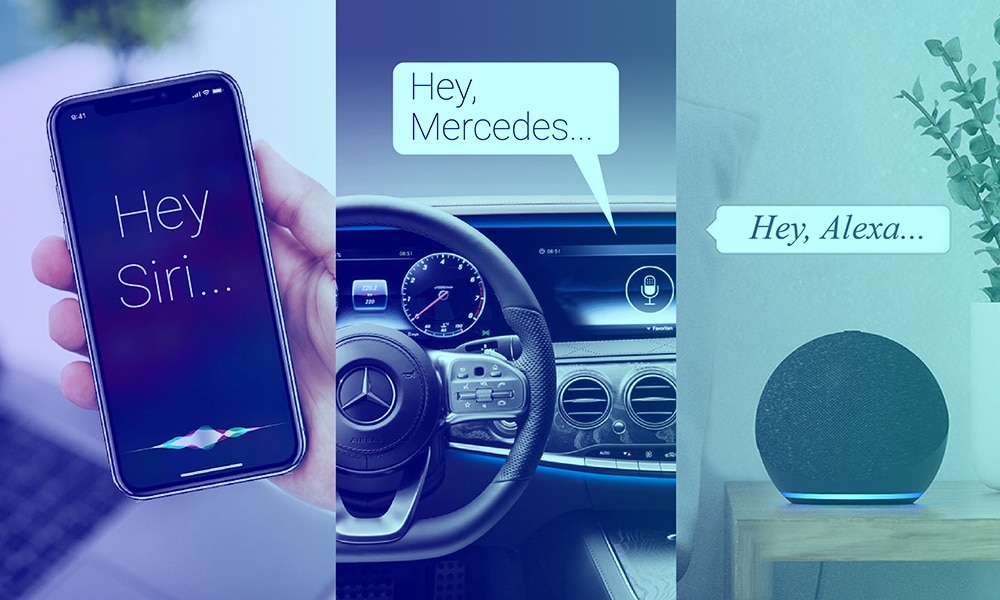
Shaip opbygger træningsdata til fuldt brandede "wake words", så kunderne siger dit brandnavn – ikke en generisk assistent. Hvert datasæt er justeret til din præcise aktiveringsfrase, hvilket forstærker brandgenkendelsen med hver interaktion og holder taleoplevelsen inden for dit eget økosystem.
Shaip understøtter altid-lyttende wake word-modeller, der kører på enheden uden at optage eller sende lyd til skyen. Wake word-træningsdata på enheden reducerer latenstid, mindsker privatlivsrisiko og sikrer, at detektionen fungerer pålideligt, selv uden en internetforbindelse.
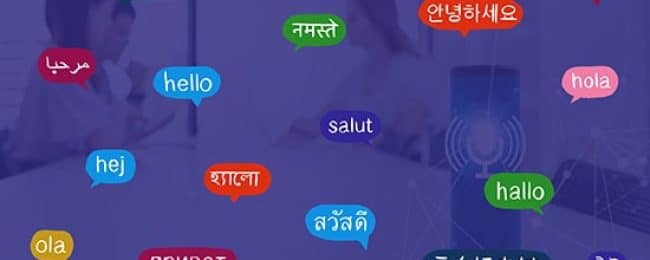
Shaip indsamler ytringer af "wake words" på tværs af over 100 sprog og regionale accenter — skotsk, canadisk, australsk, indisk engelsk og flere andre — så nøjagtigheden af detektering gælder på tværs af globale brugerbaser i stedet for at blive forringet for ikke-modersmålstalende.
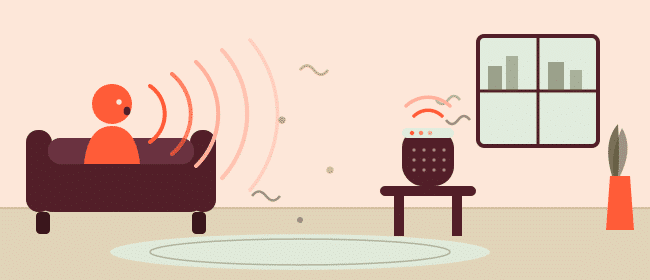
Shaip indsamler wake word-data under stille, støjende forhold, i bilen, udendørs og i fjerntliggende områder. Træning i akustisk variation i den virkelige verden reducerer falske afvisninger, når brugerne taler på afstand eller i baggrundsstøj.
Ud over det såkaldte "wake word" leverer Shaip data om ytringer og frasespotting, så enheder behandler længere kommandoer i naturligt sprog med lav latenstid. Integrerede data til nøgleordsdetektion understøtter behandling i browseren og på chippen for at opnå høj nøjagtighed og privatliv.
Forskellige fonemer skaber generelt en mere tydelig signatur og sikrer bedre nøjagtighed i resultaterne. Vælg derfor sætninger i dine data, der producerer forskellige lyde.
Gør vækkeord mere effektive ved at sætte præfikser på dem som "Hej", "Hej", "Hej" eller "OK". Det vil holde det vågne ord utvetydigt og sikre, at der ikke sker utilsigtet matchning, når du bruger triggerord i almindelig tale.
Gør dine vågne ord til en kombination af mindst seks fonemer, der let kan skelnes af en maskine og lette at sige af mennesker. For eksempel har "Alexa" seks fænomer, mens "Ok Google" har otte fænomer.
Begå ikke den fejl at bruge et enkelt ord som dit vågne ord. Wake-ord skal være lange nok til at være forskellige.
Sørg for, at de udløsende ord, du opretter, skal være enkle og unikke, så de let kan huskes.
Længere flerords wake-sætninger er svære at udtale og gør processen unødigt sværere.
En wake word-model er generelt trænet til at genkende et nej. af forskellige ytringer, så den kan reagere på forskellige påkaldelser. Men at have for mange distinkte vågne ord kan simpelthen aktivere talepipelinen, uden at du ved, hvilken ytring brugeren talte.
Faktorer som støj, afstand og variationer i accenter og sprog gør nøjagtig hotword-detektion sværere og kompleks for din AI-model.

Vores erfaring inden for stemmeteknologi hjælper os med at udvikle altid-lyttende skræddersyede wake-ord og brandede wake-sætninger hurtigt. Med stemmegenkendelse sammen med naturlig sprogbehandlingsforståelse hjælper ML-algoritmer med at transskribere tale og udføre stemmekommandoer effektivt.

Vi fokuserer på hurtigt at udvikle wake word prototyping for at sikre tilpasning af det brandede ord. En prototype fungerer som et proof of concept og hjælper med præcis træning, hurtigere time to market, accelereret test og eliminering af risici.

Oplev uafbrudt vækst og uhindret kundeengagement med en enestående stemmeassistent. Vi leverer flersprogede talegenkendelsesfunktioner, så applikationen nøjagtigt kan spotte ord og sætninger selv i miljøer med høj støj.
Det er en måde at indsamle vigtige brugerdata på såsom deres identitet, oprindelsesland, alder, køn, sprog, accenter osv. Datadiversitet bruges til at forbedre brugerorienterede algoritmer for at opnå mere præcise resultater.
Data har normalt en tendens til at generere indbyggede skævheder. Derfor, når vi indsamler data fra forskellige kilder, reduceres skævheden i resultaterne betydeligt.
Her er et par parametre for datadiversitet, som Shaip adresserer, mens han bygger vågne ord og andre samtalekommandoer.

| Race og etnicitet | hinduer, muslimer, kristne, afrikanere, europæere |
| Uddannelsesniveau | Bachelor, Graduate, Ph.D., Masters |
| Land | Kina, Japan, Indien, Korea, Dubai, Nigeria, USA, Canada |
| Køn | Mand kvinde |
| Alder | Under 10 år, 10-15, 15-25, 25-45, 45 år og derover |
| Sprog | Engelsk, japansk, tyrkisk, kinesisk, thai, hindi |
| Miljø | Lydløs, Støjende, Baggrundsmusik, Baggrundslyd/tale, Indendørs, Udendørs, Teater, Stadion, Cafeteria, I bil, Kontor, Indkøbscenter, Hjemmestøj, Trappe, Gade/Vej, Havside (blæsende) |
| Accenter (engelsk) | Skotsk engelsk, walisisk engelsk, hiberno-engelsk, canadisk engelsk, australsk engelsk, newzealandsk engelsk |
| Talestil | Hurtig/Normal/Langsom hastighed, Høj/Normal/Lav lydstyrke, Formel/Afslappet |
| Enhedspositioner | Håndholdt, Desktop |
Wake word-data for højttalere, tv'er og apparater, der skal aktiveres øjeblikkeligt og afvise baggrundssnak.
Fjernfelts, støjrobuste wake word-datasæt til håndfri assistenter i kabinen.
Lavt fodaftryks-wakeword-data for altid tændte enheder med begrænset batterikapacitet.
Brugerdefinerede data om vækkeord og -ytringer for at lokalisere assistenter på tværs af sprog og dialekter.
Privatlivsfokuserede, enhedsbeskyttede wakeword-data til håndfri kliniske og patientindstillinger.
Multimodale wake word- og kommandodata til robotter, der reagerer i realtid uden skyen.
Shaip samarbejder med dig om at vælge et fonetisk distinkt, brand-tilpasset "wake word" og definere retningslinjer for indsamling.
Shaips globale arbejdsstyrke registrerer vågeordet på tværs af nødvendige sprog, accenter, aldre, enheder og støjende miljøer.
Hver ytring transskriberes, mærkes og kvalitetskontrolleres i forhold til dine acceptkriterier.
Shaip leverer strukturerede, politikstyrede træningsdata for wake words, der er formateret til din modelpipeline.
For effektivt at implementere dit AI -initiativ har du brug for store mængder specialiserede træningsdatasæt. Shaip er en af de meget få virksomheder på markedet, der sikrer pålidelige træningsdata i verdensklasse i stor skala, der overholder lovgivningsmæssige/ GDPR-krav.
Opret, sammensæt og saml specialbyggede datasæt (tekst, tale, billede, video) fra mere end 100 nationer over hele kloden baseret på brugerdefinerede retningslinjer.
Udnyt vores globale arbejdsstyrke på mere end 30,000 erfarne og anerkendte bidragsydere. Fleksibel opgavetildeling og realtidsovervågning af arbejdsstyrkens kapacitet, effektivitet og fremskridt.
Vores proprietære platform og dygtige medarbejdere bruger flere metoder til kvalitetskontrol til at opfylde eller overgå kvalitetsstandarder, der er indstillet til indsamling af AI-træningsdatasæt.
Vores proces effektiviserer, indsamlingsprocessen gennem lettere opgavefordeling, styring og datafangst direkte fra app- og webgrænsefladen.
Oprethold fuldstændig datahemmeligholdelse ved at gøre fortrolighed til vores prioritet. Vi sikrer, at dataformater er politikstyrede og bevarede.
Curated domænespecifikke data indsamlet fra branchespecifikke kilder baseret på retningslinjer for indsamling af kundedata.
Shaip tilbyder end-to-end tale-/lyddataindsamlingstjenester på over 150+ sprog for at gøre det muligt for stemmeaktiverede teknologier at henvende sig til et mangfoldigt sæt af målgrupper over hele kloden.
Den chatbot, du har talt med, kører på et avanceret konversations-AI-system, der er trænet, testet og bygget ved hjælp af tonsvis af talegenkendelsesdatasæt. Det er den grundlæggende proces bag teknologien, der gør maskiner intelligente
Behovet for Udtalelsestræning opstår, fordi ikke alle kunder bruger de nøjagtige ord eller sætninger, mens de interagerer eller stiller spørgsmål til deres stemmeassistenter i et script-format.
Styrke teams til at opbygge verdensledende AI-produkter.


Et "wake word" er et specifikt ord eller en sætning – f.eks. "Alexa", "Okay Google" eller en brugerdefineret sætning – der aktiverer en stemmeaktiveret enhed og skifter den fra passiv til aktiv lytning. Enheden lytter kontinuerligt lokalt efter "wake word" og begynder først at behandle en anmodning, når "wake word" er registreret.
Data til træning af vågne ord er det mærkede sæt af talte optagelser, der bruges til at lære en model at genkende dens aktiveringsfrase. Effektive træningsdata for vågne ord spænder over mange talere, accenter, aldre, enheder og støjforhold, så modellen udløses pålideligt, mens den afviser tale med lignende lyd.
Et "wake word" fungerer ved at køre en lille, altid lyttende detektionsmodel, der scanner indgående lyd for målfrasen. Når modellen matcher "wake word" med tilstrækkelig sikkerhed, aktiveres enheden og begynder at behandle brugerens anmodning ved hjælp af talegenkendelse og naturlig sprogbehandling.
Et stærkt, brugerdefineret "wake word" bruger forskellige fonemer, indeholder mindst tre til fire stavelser og undgår almindelige hverdagsord for at reducere falske aktiveringer. Tilføjelse af et præfiks som "Hey" eller "OK" forbedrer særpræget. Shaip hjælper med at vælge og validere "wake words" under projektopsætningen.
Ja. Aktiveringsordregistrering på enheden kører aktiveringsmodellen lokalt, så lyd ikke optages eller sendes til skyen. Dette reducerer latenstid, beskytter privatlivets fred og holder registreringen kørende offline. Shaip indsamler træningsdata, der er specifikt egnet til implementering på enheden og i integreret tilstand.
Shaip indsamler data om træning af vågne ord på over 100 sprog og en bred vifte af regionale accenter, hentet fra en global arbejdsstyrke på tværs af over 100 lande. Denne bredde reducerer nøjagtighedsforskelle for ikke-modersmålstalende og understøtter globale produktlanceringer.
Shaip anvender flere kvalitetskontroller – transskriptionsgennemgang, acceptkriterier og overvågning af arbejdsstyrken – så datasættene opfylder målsætningens nøjagtighed før levering. Diverse data af høj kvalitet reducerer både forekomsten af falske accepter og falske afvisninger i den implementerede model.
Et "wake word" aktiverer enheden; en ytring er den talte anmodning, der følger. "Wake word detection" er en snæver, altid aktiv opgave, mens "ytringsforståelse" involverer fortolkning af varierende naturligt sproglige formuleringer. Shaip leverer træningsdata til både "wake word detection" og indsamling af ytringer.
En ytring er en sætning, som en bruger siger for at fremsætte en anmodning til stemmekommandosoftware. Softwaren identificerer brugerens hensigt ud fra ytringen og reagerer i overensstemmelse hermed. I modsætning til en hel sætning er en ytring en taleenhed, der muligvis ikke formidler en fuld tanke og ofte indeholder pauser. Eksempler: "Vis mig den seneste film - den, der udkom i sidste uge," eller "Er butikken på 22nd Street åben nu?"
Et kaldenavn er det nøgleord, der bruges til at udløse en specifik "færdighed" i stemmesoftware. Det kan indeholde navne på personer eller steder og kombineres med en handling, kommando eller et spørgsmål. Enhver brugerdefineret færdighed skal have et kaldenavn for at starte den.
Vågneord kaldes også triggerord, hot ord, aktiveringsord, påkaldelsesord, vækkefraser og ytringer.
Alexa bruger adskillige indbyggede mikrofoner til at registrere sit "wake word", mens den filtrerer baggrundsstøj fra. For at forhindre falske positiver og negative resultater begynder den først aktiv lytning, når den har registreret "Alexa".

Vi bruger cookies til at forbedre din oplevelse på vores side. Ved at bruge vores side giver du samtykke til cookies.
Administrer dine cookie-præferencer nedenfor:
Væsentlige cookies aktiverer grundlæggende funktioner og er nødvendige for, at webstedet fungerer korrekt.
Google Tag Manager forenkler administrationen af marketingtags på dit websted uden kodeændringer.
Statistikcookies indsamler oplysninger anonymt. Disse oplysninger hjælper os med at forstå, hvordan besøgende bruger vores hjemmeside.
Google Analytics er et effektivt værktøj, der sporer og analyserer hjemmesidetrafik for at træffe informerede markedsføringsbeslutninger.
Tjenestens URL: policies.google.com (åbner i et nyt vindue)
Marketingcookies bruges til at følge besøgende på hjemmesider. Hensigten er at vise annoncer, der er relevante og engagerende for den enkelte bruger.
Google Ads er en online annonceringsplatform, der gør det muligt for virksomheder at oprette målrettede annoncer, der vises i Googles søgeresultater og på partnersider.
Tjenestens URL: policies.google.com (åbner i et nyt vindue)
HubSpot er en alt-i-én marketing-, salgs- og kundeserviceplatform, der strømliner forretningsvækst.
Tjenestens URL: legal.hubspot.com (åbner i et nyt vindue)
Du kan finde flere oplysninger i vores Cookiepolitik og Privatlivspolitik.