OCR-træningsdata og annotationstjenester

OCR-træningsdatatjenester og datasæt til ML/AI

Brugerdefineret dataindsamling, ekspertannotering og standard OCR-datasæt — fakturaer, kvitteringer, håndskrift, tabeller og flersprogede dokumenter — annoteret med 99 % nøjagtighed*, så dine modeller læser ethvert dokument på ethvert sprog.

Optisk karaktergenkendelse
Globalt godkendte bidragydere
100 K+
Nøjagtigheds-SLA
0 %+
Understøttet sprog
10 +
Intern global arbejdsstyrke
1000 +
🔒 HIPAA-kompatibel
???????? GDPR-klar
✅️ ISO 27001-certificeret
✅️ SOC 2 TRady
Hvad er OCR-træningsdata – og hvorfor Shaip

OCR-datasæt og dataannotationstjenester bygget til produktionsnøjagtighed

OCR-træningsdata er et mærket sæt af dokumentbilleder – scanninger, fotos og PDF'er af trykt eller håndskrevet tekst – parret med nøjagtige teksttransskriptioner og afgrænsningsboksannotationer. Maskinlæringsmodeller lærer ud fra disse billede-til-tekst-data at omdanne dokumenter til redigerbar, maskinlæsbar tekst.

Uanset om du finjusterer en dokumentforståelsesmodel eller bygger optisk tegngenkendelse fra bunden, sætter kvaliteten af ​​dine mærkede data din nøjagtighedsgrænse. Shaip kombinerer domæneekspert-annotatorer med en gennemprøvet Six Sigma QA-proces og en sikker, kompatibel platform – og leverer faktura-, kvitterings-, håndskrifts- og flersprogede OCR-data, som dine modeller kan stole på, til en brøkdel af prisen for at bygge det internt.

Ocr træningsdata
Hvad vi tilbyder

OCR-datatjenester: indsamling, annotering og standarddatasæt

📥

1. Indsamling af brugerdefineret OCR-data

Vi indsamler dokumentbilleder præcist efter dine specifikationer – fakturaer, kvitteringer, ID'er, håndskrift og flersprogede scanninger – på tværs af virkelige forhold og edge cases, i overensstemmelse med gældende regler i over 60 lande.

🖍️

2. OCR-dataannotationstjenester

Tekstranskription på tegn-, ord- og rækkeniveau plus mærkning af afgrænsningsbokse, firkanter og polygoner udført af domæneeksperter, med flerrunde Six Sigma QA.

📦

3. Standard OCR-datasæt

Licensér færdige, kvalitetskontrollerede OCR-datasæt i dag – håndskriftsgenkendelse, kvittering og faktura, tabel- og flersprogede dokumentdata – for hurtigt at kunne lave prototyper og benchmarks.

OCR-brugstilfælde

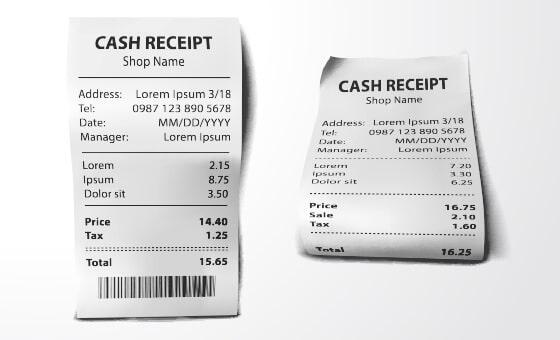
Faktura- og kvitterings-OCR-data

Linjeposter, totaler, moms- og leverandørfelter mærket til faktura-OCR og kvitterings-OCR — driver automatisering af kreditorer og udgifter.

Datasæt til håndskriftgenkendelse

Freestyle-datasæt af håndskrevne tekster på tværs af mange forfattere, stilarter og sprog til ICR og modeller til genkendelse af kursiv.

Tabel OCR-datasæt

Udtrækning på række-, kolonne- og celleniveau fra komplekse tabeller og strukturerede tabeldokumenter.

ID- og KYC-dokument OCR

Pas, kørekort og ID-kort med nøgleværdiannotation til identitetsbekræftelse og KYC.

OCR-data for formularer og billetter

Flybilletter, ansøgninger og strukturerede formularer med feltniveaumærkning og nøgleværdiudtrækning.

Datasæt til genkendelse af scenetekst

Skiltning, etiketter og produkttekst optaget under naturlige, virkelige billedforhold.

Nøglefunktioner: Hvorfor vælge Shaips Table OCR?

  • Dokumentbehandling i realtid: Eliminer fejl, og koncentrer dig om det, der virkelig betyder noget - at få din virksomhed til at vokse.
  • Indfang data fra enhver kilde: Importer ubesværet data fra en lang række formater – PDF'er, scanninger, papirdokumenter, e-mails, API'er og mere.
  • Overlegen nøjagtighed: Vores OCR API'er er grundigt testet og foruddannet på millioner af dokumenter, hvilket sikrer enestående pålidelighed.
  • Forenkle arbejdsgange: Opret automatiserede processer til håndtering af filimport, dataformatering, validering, godkendelser, eksporter og integrationer.
  • Spar tid og penge: Minimer tiden brugt på ineffektive manuelle opgaver og undgå dyre dataindtastningsfejl.
  • Sømløs integration: Forbind Shaip OCR med dine eksisterende værktøjer til effektiv dataindsamling, eksport, opbevaring, bogføring og mere.
  • Øg produktiviteten: Giv dit team mulighed for at fokusere på kerneaktiviteter, mens Shaip styrer resten, hvilket øger din organisations produktivitet!

Standardkatalog

Standard OCR-datasæt klar til licensering

Forudbyggede, kvalitetskontrollerede OCR-datasæt, som du kan licensere i dag – håndskrift, kvittering og faktura, tabel, flersprogede data og scenetekstdata – eller bruge dem som udgangspunkt for en brugerdefineret OCR-datasætopbygning.

Stregkode scanning videodatasæt

5k-videoer af stregkoder med en varighed på 30-40 sek. fra flere geografier
Stregkode scanning videodatasæt

Brugsscenarie: Objektgenkendelsesmodel

Format: Videoer

Volumen: 5,000+

Annotation: Nej

Fakturaer, PO, Kvitteringer Billeddatasæt

15.9 billeder af kvitteringer, fakturaer, indkøbsordrer på 5 sprog, dvs. engelsk, fransk, spansk, italiensk og hollandsk

Fakturaer, PO-kvitteringer, billeddatasæt

Brugsscenarie: Dokumentgenkendelsesmodel

Format: Billeder

Volumen: 15,900+

Annotation: Nej

Tysk & UK fakturabilleddatasæt

Leverede 45 billeder af tyske og britiske fakturaer

Billeddatasæt for tyske og britiske fakturaer

Brugsscenarie: Fakturagenteringsmodel

Format: Billeder

Volumen: 45,000+

Annotation: Nej

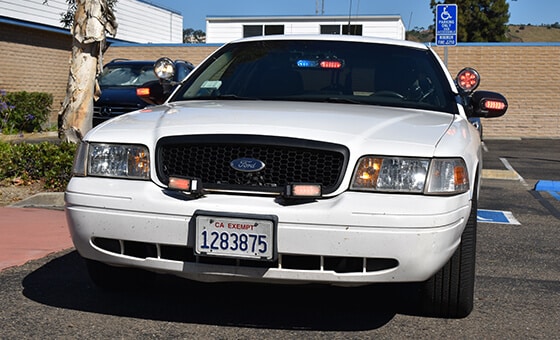
Datasæt til køretøjets nummerplade

3.5k billeder af køretøjsnummerplader fra forskellige vinkler

Køretøjets nummerpladedatasæt

Brugsscenarie: Nr. Pladegenkendelse

Format: Billeder

Volumen: 3,500+

Annotation: Nej

Håndskrevet dokument billeddatasæt

Samlede og kommenterede 90 dokumenter på engelsk, fransk, spansk, tysk, italiensk, portugisisk og koreansk

Håndskrevet dokumentbilleddatasæt

Brugsscenarie: OCR-model

Format: Billeder

Volumen: 90,000+

Annotation: Ja

Dokumentdatasæt til OCR

23.5 dokumenter på japansk, russisk og koreansk fra skilte, butiksfacader, flasker, dokumenter, plakater, flyers.

Dokumentdatasæt til ocr

Brugsscenarie: Flersproget OCR-model

Format: Billeder

Volumen: 23,500+

Annotation: Ja

Europæisk kvitteringsbilleddatasæt

11.5k+ billeder af kvittering fra større europæiske byer

Europæisk kvitteringsbilleddatasæt

Brugsscenarie: Objektdetektionsmodel

Format: Billeder

Volumen: 11,500+

Annotation: Nej

Faktura/Kvittering Datasæt

75k+ kvitteringer på flere sprog

Fakturakvitteringsdatasæt

Brugsscenarie: Kvitterings-AI-modeller

Format: Billeder

Volumen: 75,000+

Annotation: Nej

Af industri

Branchespecifikke OCR-dataløsninger

🏥

Sundheds- og medicinsk OCR

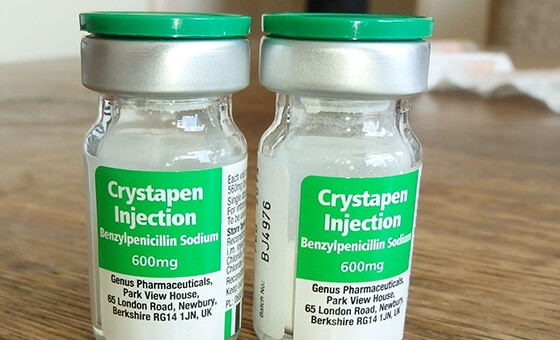
Datasæt med recepter, laboratorierapporter og medicinske formularer — HIPAA-kompatibel håndtering af kliniske dokumenter med kunstig intelligens.

🏦

Bank- og FinTech-optimeret referencegenkendelse (OCR)

Faktura-, bankudtog-, check- og KYC-dokumentdata til udtrækning af finansielle dokumenter.

🚚

Logistik og forsyningskæde OCR

Fragtsedler, følgesedler og konnossement til forsendelse og fragtautomatisering.

🛡️

OCR for forsikringsdokument

Skadeformularer, policedokumenter og håndskrevne indsendelser mærket i målestoksforhold.

🛒

Detailhandel og forbrugerprodukters OCR

Kvitterings-, prisskiltnings- og hyldefortegnelsesdata til udgifts-, loyalitets- og merchandising-kunstig intelligens.

⚖️

OCR for juridisk og offentlig sektor

Digitaliseringsdatasæt til kontrakter, registreringer og arkivscanninger til dokumentbehandlingsprogrammer.

Vores proces

Vores OCR-dataannoterings- og kvalitetssikringsproces

Hvordan opnås OCR-nøjagtighed? Gennem de rigtige annotationstyper plus menneskelig kvalitetssikring i flere runder. Vi mærker på tegn-, ord- og rækkeniveau ved hjælp af afgrænsningsboks-, firkant- og polygonannotationer, og verificerer derefter hver batch før levering – med et mål om 99 % nøjagtighed.*

1

OCR-dataindsamling

Definer dokumenttyper, sprog og kantsager; find eller indsaml kompatible dokumentbilleder.

2️

OCR-dataannotering

Transskription af tegn/ord/rækketekst + afgrænsningsboks, quad- og polygonmærkning udført af uddannede eksperter.

3

Flerrunde QA

Uafhængig gennemgang og Six Sigma-tjek måler tegn- og ordfejlraten i forhold til din SLA.

4

Levering og modelsupport

Send i dit modelklare format; finjuster feedbacken og udvid datasætdækningen over tid.

Vellykkede historier

OCR-tekstdetektion og transkriptionsannotering

OCR-tekstdetektion og transskriptionsannotation

Shaip byggede en end-to-end OCR-annotationspipeline — afgrænsningsbokse på ordniveau med transkription på tegnniveau på tværs af mere end 10 tekstkilder, der håndterede buet skiltning, falmede kvitteringer, håndskrift og blandede skrifttyper. Fem attributlag og dobbelt QA leverede produktionsklare datasæt med 99% nøjagtighed.

Hvorfor vælge Shaip

Hvorfor vælge Shaip som din OCR-datapartner

Shaip har brugt årevis på at finde, indsamle og annotere AI-træningsdata på tværs af alle modaliteter. For optisk tegngenkendelse betyder det dybde, du ikke kan opbygge natten over - global rækkevidde, domæneekspertise, sikkerhed i virksomhedsklassen og proprietære værktøjer bag hvert OCR-datasæt.

🌍

Global rækkevidde

Data indhentet og kurateret fra mere end 60 landemere end 65 sprog på tværs af mere end 70 emner — en dækning, som de fleste leverandører ikke kan matche.

🎓

Domæneekspert-arbejdsstyrke

Mere end 30,000 uddannede annotatorer og branchespecialister leverer præcis, kontekstbevidst OCR-annotering, ikke generisk mærkning.

🔐

Virksomhedssikkerhed og overholdelse

GDPR, HIPAA, CCPA, ISO 9001:2015, ISO 27001 og SOC 2 Type II — med fortrolighedsaftaler og sikker datahåndtering fra start til slut.

🧩

Proprietær platform

Shaip Manage , Shaip Work og Shaip Intelligence driver projektovervågning, global arbejdsstyrkekoordinering og automatiseret datavalidering.

💸

Hurtigere og lavere omkostninger

Få kvalitetsdata til en brøkdel af prisen for at bygge det selv – og få dine modeller hurtigere på markedet.

Kvalitet du kan benchmarke

Six Sigma QA og målbare nøjagtighedsmål (tegn- og ordfejlrate) betyder data, du kan stole på i produktionen.

Lad os diskutere dine OCR-træningsdatabehov i dag

Fra dataindsamling til annotering, licensering og validering – vi hjælper dig med at komme hurtigere på markedet med data, du kan stole på.

Kontakt os

OCR, eller optisk tegngenkendelse, er en teknologi, der konverterer trykt eller håndskrevet tekst i billeder eller scannede dokumenter til maskinlæsbar tekst. Det fungerer ved at træne AI-modeller med mærkede datasæt til at genkende mønstre og tegn i forskellige formater som kvitteringer, fakturaer og formularer.

OCR er afgørende for at automatisere opgaver som dokumentbehandling, dataudtrækning og digitalisering. Det hjælper virksomheder med at spare tid, reducere fejl og forbedre effektiviteten i håndteringen af ​​store mængder fysiske eller scannede dokumenter.

Maskinlæring forbedrer OCR ved at træne modeller med forskellige datasæt, så de kan håndtere variationer i skrifttyper, håndskriftsstile, layouts og sprog. Over tid lærer modellerne at generalisere og forbedre genkendelsesraterne.

OCR kan behandle en bred vifte af dokumenter såsom kvitteringer, fakturaer, håndskrevne formularer, pas, medicinske etiketter, billetter og endda komplekse tabeller i scannede PDF'er eller billeder.

Tabel-OCR udtrækker strukturerede data fra tabeller i scannede dokumenter, PDF'er eller billeder. Den konverterer rækker og kolonner til maskinlæsbare formater som Excel, hvilket gør databehandling hurtigere og mere præcis.

OCR bruges i vid udstrækning i brancher som sundhedspleje, finans og e-handel. Det automatiserer dataudtrækning fra patientjournaler, fakturaer, kvitteringer og andre dokumenter, hvilket forbedrer den operationelle effektivitet på tværs af sektorer.

Flersprogede OCR-modeller trænes med datasæt, der dækker forskellige sprog, dialekter og skrifttyper. Dette gør det muligt for dem præcist at genkende og behandle tekst på tværs af forskellige skrifttyper og typografier.

Træning af OCR-modeller involverer håndtering af forskellig håndskrift, skrifttyper, layout og sprog. Det er også en central udfordring at sikre nøjagtig genkendelse af komplekse dokumenter som medicinske kvitteringer eller flersproget indhold.

Shaip tilbyder OCR-datasæt af høj kvalitet, der er tilpasset specifikke behov, herunder kvitteringer, fakturaer, håndskrevne formularer og flersprogede dokumenter. Disse datasæt er kurateret, annoteret og valideret for at sikre maksimal nøjagtighed og pålidelighed.

Shaips OCR-træningsløsninger er yderst skalerbare og designet til at levere exceptionel nøjagtighed. Deres proces kombinerer avancerede AI-værktøjer med menneskelig ekspertise, hvilket sikrer pålidelige resultater selv med store datasæt.

Prisen afhænger af typen, mængden og kompleksiteten af ​​det ønskede datasæt. Virksomheder kan kontakte Shaip direkte for at drøfte deres specifikke behov for at få tilpassede priser.