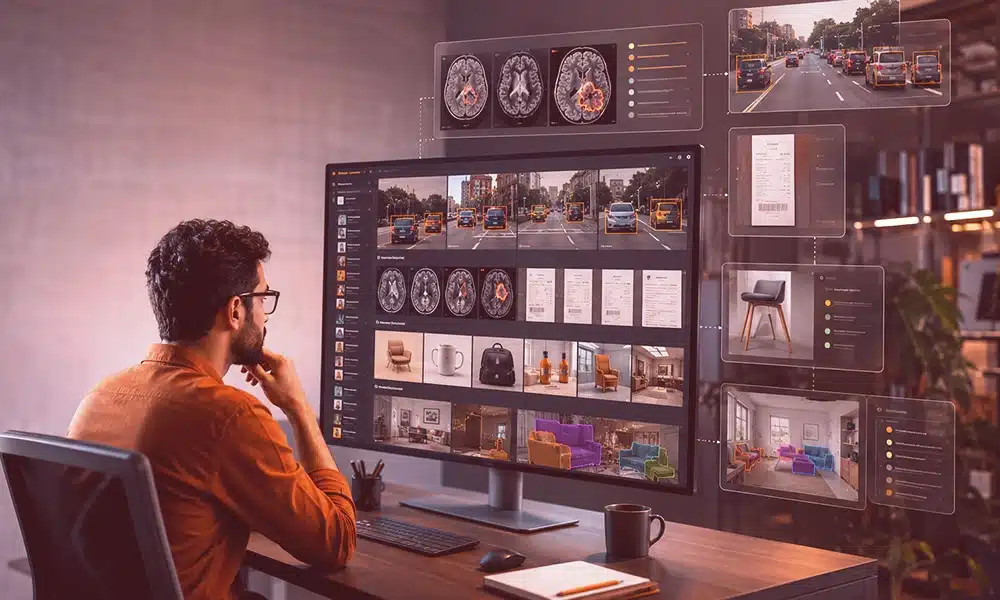
En computer vision-model er kun så skarp som de billeder, du træner den på. Giv den et rent, velmærket sæt, og den lærer at spotte tumorer, læse kvitteringer eller holde en selvkørende bil i sin vognbane. Giv den støj, og den gør tingene med sikkerhed forkert. Derfor er de rigtige billeddatasæt til computer vision vigtigere end modelarkitekturen for de fleste nye teams – og hvorfor gratis, open source-datasæt fortsat er den hurtigste måde at lave prototyper på, før du investerer i brugerdefinerede data.
Nedenfor er 22 af de mest nyttige open source-datasæt, grupperet efter opgave, plus en kort guide til, hvordan man vælger et, og hvor man kan kigge ud over denne liste. Det globale computer vision-marked blev vurderet til 20.75 milliarder dollars i 2025 og forventes at vokse fra 24.14 milliarder dollars i 2026 til 72.80 milliarder dollars i 2034 ( Fortune Business Insights, 2025 ), så efterspørgslen efter træningsbilleder af høj kvalitet stiger kun.
Nøgleforsøg
- Open source-billeddatasæt lader dig prototype computer vision-modeller gratis, før du idriftsætter brugerdefinerede data.
- Match datasættet med opgaven: klassificering, detektion eller segmentering kræver hver især forskellige betegnelser.
- Benchmark-sæt som ImageNet, COCO og Open Images forbliver branchestandarder.
- Gratis datasæt matcher sjældent din præcise use case – planlæg et brugerdefineret datatrin.
Hvad er billeddatasæt til computer vision?
Billeddatasæt til computer vision er organiserede samlinger af mærkede billeder, der bruges til at træne og validere modeller, der fortolker visuel information. Hvert billede indeholder annotationer – en klasseetiket, afgrænsningsbokse eller masker på pixelniveau – der lærer en algoritme, hvad den ser på. Annotation er det mærkningslag, der omdanner rå pixels til overvågede træningssignaler. Uden det har en model billeder, men ingen lektie at lære af.
Opgaver i billeddatasæt: Klassificering, segmentering, detektion og mere

Billedklassificering er en af de mest grundlæggende computer vision-opgaver. I denne proces lærer en model at tildele en etiket til et helt billede baseret på dets indhold. For eksempel kan et billedklassificeringsdatasæt hjælpe en model med at skelne mellem billeder af katte og hunde eller identificere forskellige typer planter. Denne opgave er afgørende for applikationer som automatiseret fototagging, sygdomsdiagnose fra medicinske billeder og benchmarks for scenekategorisering.
Objektdetektion tager tingene et skridt videre ved ikke blot at identificere tilstedeværelsen af objekter i et billede, men også ved at præcisere deres placering ved hjælp af afgrænsningsbokse. Datasæt til objektdetektion, såsom dem, der indeholder kommenterede billeder med afgrænsningsbokse, er afgørende for applikationer som fodgængerdetektion i autonome køretøjer, sikkerhedsovervågning og detailhandelsanalyser. Objektdetektion er også en nøglekomponent i udviklingen af robuste computervisionsalgoritmer til virkelige scenarier.

Semantisk segmentering involverer klassificering af hver pixel i et billede i en specifik kategori, hvilket giver en detaljeret forståelse af scenen. Denne pixelniveau-trimap-segmentering er især vigtig i opgaver som medicinsk billeddannelse, hvor præcis afgrænsning af organer eller tumorer er påkrævet, og i bymiljøer til autonom kørsel, hvor det er afgørende at skelne mellem veje, fortove og køretøjer.
Hvad er de bedste billeddatasæt til generelle formål?
Generelle datasæt er store, bredt mærkede samlinger, der bruges til at benchmarke modeller og foruddanne netværk før finjustering af en mere snæver opgave.
- IMAGEnet — 1.2 millioner billeder på tværs af 1,000 kategorier, organiseret efter WordNet-hierarkiet. Benchmarken, der lancerede moderne deep learning.
- Google Åbne Billeder V7 — cirka 9 millioner billeder kommenteret på tværs af 600 objektklasser med etiketter, bokse, segmentering og relationer.
- CIFAR-10 — 60,000 bittesmå 32×32 farvebilleder i 10 klasser. Et standard startsæt til hurtige eksperimenter.
- Oxford-IIIT kæledyrsdatasæt — 37 kæledyrsracer med racemærker, hovedbokse og trimap-segmentering på pixelniveau.
- SA-1B (Segmenter hvad som helst) — over 11 millioner billeder og 1.1 milliarder masker, det største tilgængelige segmenteringsdatasæt.
- ADE20K — 25,000+ tæt annoterede scenebilleder, et vigtigt benchmark for semantisk segmentering.
- CelebA — 200,000+ billeder af kendisser med 40 attributannotationer pr. billede.
- YouTube-8M — millioner af video-ID'er med maskingenererede visuelle entitetsetiketter til videoforståelse.
Hvordan vælger man det rigtige computer vision-datasæt?

Vælg et datasæt ved at matche tre ting: opgaven, annotationstypen og domænet. Et klassifikationsprojekt har brug for klassenavne; et detektionsprojekt har brug for afgrænsningsbokse; et segmenteringsprojekt har brug for masker – brug af den forkerte navnetype spilder uger. Tjek derefter domænegabet. En model, der er trænet på rene stockfotos, snubler ofte over kornede optagelser fra den virkelige verden, på samme måde som en person, der kun har studeret parlørspansk, fryser til i en hurtig gadesamtale. Jo tættere datasættets billeder er på dine implementeringsforhold – belysning, vinkel, opløsning, demografi – jo mindre gentræning skal du bruge.
Væg også licensvilkår (mange forskningsdatasæt udelukker kommerciel brug), klassebalance og etiketternes nøjagtighed. På tværs af hundredvis af computer vision-projekter oplever Shaip-teamet konsekvent, at offentlige datasæt fører dig til en fungerende prototype, men sjældent længere end det – produktionsnøjagtighed kræver næsten altid data, der afspejler dine specifikke kameraer, miljøer og edge-cases.
Hvornår bør du i stedet opbygge et brugerdefineret datasæt?

Byg brugerdefinerede data, når mangler i nøjagtighed, dækning eller overholdelse af regler begynder at koste dig dyrt. Forestil dig et mellemstort forsikringsselskab, der forsøger at automatisere estimater af bilskader: Offentlige køretøjsdatasæt viser rene studiebilleder, men reelle skader ankommer som dystre, rodede telefonbilleder af bulede kofangere. Intet åbent datasæt matcher det, så modellen præsterer under niveau, indtil den trænes på repræsentative billeder. Det er vendepunktet.
Når offentlige sæt ikke opfylder dine edge cases, kan du bruge brugerdefineret dataindsamling og annotationskilder og etiketter, der afspejler dine nøjagtige forhold – inklusive de sjældne, vanskelige scenarier, der afgør, om en model er demoklar eller produktionsklar. Brugerdefinerede data er også vigtige, når licens- eller privatlivsregler udelukker offentlige sæt, når dine klasser knap nok vises i åbne datasæt, eller når etikettkvaliteten skal overstige en højere standard, end crowdsourcing-annoteringer kan garantere. Hvis dit projekt er vokset ud af, hvad gratis datasæt kan tilbyde, er næste skridt at fastlægge samlingsvolumener, annotationsspecifikationer og overholdelseskrav, der er specifikke for din use case.
Hvordan kan Shaip hjælpe med brugerdefinerede computer vision-datasæt?
Shaip bygger brugerdefinerede billeddatasæt, der er udviklet til præcis din model, dit miljø og dine edge-cases – og går ud over, hvad et gratis datasæt kan levere. Hvor åbne data er generiske, starter vores arbejde med dit problem: de kameraer, du implementerer, den belysning og de vinkler, du står over for, de sjældne scenarier, der forstyrrer nøjagtigheden i produktionen. Sådan omsættes det til en administreret, end-to-end-tjeneste: